导读 · 这本手册怎么用#
这是一份“跟着代码学”的手册。 它不代替教科书,而是把 F:\Steganography 项目背后的信息隐藏与机器学习知识,按零基础本科生可以 接受的顺序拆开:先用直觉和例子讲清楚“为什么”,再带你看项目里“怎么实现”, 最后让你亲手跑实验、改代码。
0.1 读者对象与起点#
你只需要具备这些前提,其余内容手册会逐步补齐:
会用鼠标操作电脑、能安装软件(Windows 环境);
上过大学数学公共课或愿意遇到公式时“先跳过、再回头”;
有一点编程基础更好,但没有也没关系——第 2 章会带你把 Python 用到够用;
至少有 12 周(约 3 个月)的耐心,每周 6–8 小时;想深入 6–12 个月请看附录 F。
新手提示| 如果你连 Python 都没装过,不要慌:前两周就是专门为这种情况设计的。你不需要成为程序员,只需要成为“能读懂并修改这个项目的人”。
0.2 本手册的阅读约定#
手册里反复出现五种小方块,含义如下:
标记 |
含义 |
|---|---|
新手提示 |
把容易卡住的概念换成大白话或类比,让你顺利往下走 |
避坑提醒 |
初学者最容易踩的坑:数值类型、参数不一致、误读统计量等 |
动手做 |
必须亲自动手的小实验,只读不练等于没学 |
想一想 |
不需要标准答案的思考题,用来检验自己是否真的理解 |
回到项目看代码 |
指出应当打开哪个文件、读哪一段,建立“概念→代码”的映射 |
0.3 12 周快速入门路线总览(6–12 个月深入版见附录 F)#
路线遵循“载体基础 → 隐写算法 → 隐写分析 → 机器学习 → 工程加速 → 综合 实践”的自然顺序。每一周都对应可运行的代码或可复现的实验:
周次 |
主题 |
对应章节 |
动手成果 |
|---|---|---|---|
第 1 周 |
数字图像与二进制 |
第 1 章 |
能亲手查看一张图的像素与位平面 |
第 1 周(补充) |
JPEG 与 DCT 系数 |
第 1½ 章 |
能解释量化表如何决定隐写容量 |
第 2 周 |
Python/NumPy/Pillow |
第 2 章 |
跑通 GUI 或 run_e2e.py,能读写图像数组 |
第 3–4 周 |
LSB 隐写与盲分析 |
第 3 章 |
藏一句话→用卡方/RS 检测到它 |
第 5 周 |
矩阵编码与 F5 |
第 4 章 |
用汉明码做到“改动更少、藏得更多” |
第 6 周 |
nsF5、湿纸与哈希键控 |
第 5–6 章 |
读懂 ns5_core.py,解释湿纸求解 |
第 7 周 |
机器学习基础 |
第 7 章 |
能讲清特征/标签/过拟合/AUC |
第 8–9 周 |
机器学习隐写检测 |
第 8 章 |
跑通 v1 11 维与 v2 143 维两套管线;理解 SRM 与 143d/53d 双版本模型 |
第 10 周 |
C++/GPU/数据工程/GUI |
第 9 章 |
看懂加速原理、自校验机制与多源数据集管线(SRM/BOSSbase) |
第 11–12 周 |
综合项目与汇报 |
第 10–11 章 |
完成一个可演示的改进实验 |
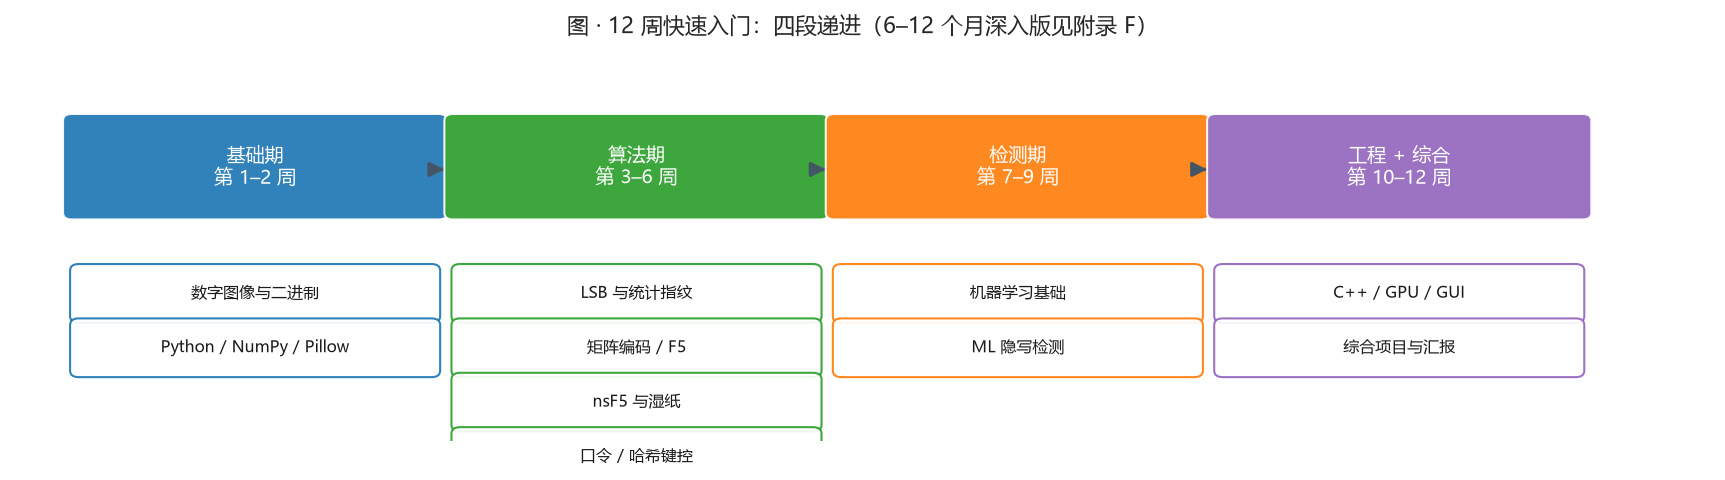
动手做| 请把这张表抄成一张打卡表贴在桌前,或直接使用附录 C 的检查表。每周结束时勾掉一行,并回答该章末尾的“想一想”。
想深入、想做出成果? 上面是 12 周的“入门”路线;如果你有 6–12 个月,请看 附录 F 的深入路线图——同样是这些内容,但按“基础 / 提高 / 深化 / 实战”四段放慢加深,并给出一条可选的“算法 / 检测 / 工程 / 研究”主线。
0.4 学完以后,你应该能做到#
用自己的话解释:隐写、隐写分析、嵌入效率、收缩、湿纸编码、伴随式;
说出 LSB 隐写为什么会被卡方检验与 RS 分析发现;
手算一个 p=3 的汉明矩阵嵌入例子(块内最多改 1 位);
解释 nsF5 与 F5 的本质区别,以及为什么“无收缩”更重要;
解释图像哈希键控如何实现解码自同步,并说明它的局限;
解释机器学习二分类的完整流程,包括为什么要按照片分组交叉验证;
读懂 v1 的 11 维与 v2 的 143 维特征(含 SRM 统计),能解释 143d 稳健版与 53d 可解释版的双模型策略;
讲清 C++ DLL 与 GPU 加速分别加速了什么,为什么需要一致性校验;
独立完成一个小的改进实验并写出诚实的结果分析。
0.5 项目地图:先认识你要学的代码#
整个项目是一个“研究工具”:既能做算法实验,也打包成带 GUI 的软件。先记住这些关键文件,后面每一章都会回来找它们:
文件 |
角色 |
学习顺序 |
|---|---|---|
src/image_io.py |
图像读写封装:打开/保存 8bit 灰度与彩色图 |
第 2 章 |
src/ns5_core.py |
算法核心:汉明码、湿纸、哈希键控、嵌入/解码 |
第 3–6 章 |
src/steganalysis.py |
盲隐写分析:卡方、RS、综合概率与判读 |
第 3 章 |
src/efficiency.py |
码族与嵌入效率理论/实测曲线 |
第 4 章 |
src/matrix_demo.py |
伴随式查找的教学演示逻辑 |
第 4 章 |
src/fsfeatures.py + cpp/fsfeatures.dll |
v1 11 维统计特征的 ctypes 绑定(v2 143 维见 featurize_v2.py) |
第 8 章 |
src/make_dataset.py / train_model.py |
数据集生成(v1/v2 特征、SRM、多源)与训练/评估 |
第 8 章 |
src/ml_predict.py |
单图 ML 判定封装(143d/53d 双版本 + 灵敏度) |
第 8 章 |
src/cppembed.py + cpp/nsf5embed.dll |
C++ 嵌入/置乱热路径与自校验 |
第 9 章 |
gpu/*.py |
PyTorch 批量特征(v1 11 维 / v2 143 维)与 GPU 训练 |
第 9 章 |
src/gui.py |
tkinter 图形界面,含教学面板 |
第 9 章 |
src/test_core.py 等测试 |
验证嵌入往返、分析与误报的回归测试 |
全程 |
src/featurize_v2.py + src/srm_filter.py + gpu/featurize_v2_gpu.py |
v1.4 新增:30 核 SRM 预处理与 143 维 v2 特征(CPU/GPU 双实现) |
第 8–9 章 |
回到项目看代码| 建议从现在起保持项目窗口打开。手册里提到某个文件时,就切过去找到它;第 2 章之后,多数知识点都要求你“先运行、再阅读”。
0.6 学习小贴士#
先跑通,再读懂。 很多概念在纸上绕,跑一次端到端脚本就通了;
公式分两步消化。 第一遍只看结论和直觉,第二遍再回到推导;
用自己的话复述。 每章小结能讲给同学听,才算掌握;
记录实验日志。 改了哪些参数、结果如何,是最后综合项目最宝贵的材料;
善用测试。 项目自带的 test_core.py / test_steg.py 是最快的“对不对”裁判。
想一想| 在你开始之前,先花 5 分钟回答:加密和隐写有什么不同?如果你说不清,太好了——这正是第 3 章要解决的第一个问题。
0.7 v1.4.0 更新说明(2026-09-06)#
本手册 9 月 3 日初稿对应项目 v1.3;9 月 6 日项目更新到 v1.4.0,本版手册已同步。隐写算法部分(第 1–6 章)不受影响;机器学习与工程部分补充了 8.8 与 9.7 两节,并把旧指标标注为“v1 基线”。
2026-10 更新:项目已迭代至 v1.9.0——在 v1.8.4 的 nsf5stego 命令行工具与 Windows 安装版(用法见附录 B 与附录 H)之上,命令行新增 JPEG 压缩域(--jpeg)与实验档案一键重跑(repro),手册补入第 1½ 章讲清 JPEG 与 DCT 系数;算法与检测原理章节不受影响。
ML 检测从 11 维特征 + LR/XGB(AUC 约 0.75–0.79)升级为 143 维 LGB 默认版(8-split 平均 0.8980)与 53d 可解释版(0.8461):143d 更准、53d 每一维都能解释,详见 8.8 与
docs/RESULTS.md;新增 SRM 高通滤波预处理、143 维 v2 特征与 12 档变体,并补入真实 JPEG 干净样本与 BOSSbase 全量多源数据,详见 8.8 与 9.7;
项目迁移到新 GitHub 仓库(Yukinoshita-lin/nsf5-steganography),许可证改为 Apache-2.0 并新增 NOTICE;
术语表、命令速查、12 周打卡表与概念→代码定位表已同步补充 v1.4 内容。