第 11 章 · 边界、伦理与继续前进(穿插学习)#
11.1 法律与伦理边界#
隐写是双刃剑:它支撑版权水印、媒体溯源、隐蔽认证等正当应用,也可能被用于 恶意隐蔽通信。学习与研究的正确姿势是:
只在自有数据、公开数据集或经授权场景做实验;
把工具用于“检测与取证”而非“协助隐藏”;
发表结果时说明局限与误报风险,不夸大检测能力;
不把他人的隐私图像当作练习载体(照片数据要脱敏、授权)。
避坑提醒| 这个项目的隐写分析部分(卡方/RS/ML)正是“盾”的用途:监管与取证需要它来发现可能的隐蔽信道。研究攻击面之前,先想清楚 你的实验数据与使用目的。
11.2 项目已知局限(看懂边界才算真正读懂)#
载荷支持 UTF-8 文本(中文可直接嵌入);更实际的限制是仅支持文本、不支持文件;
彩色图只使用 R 通道,容量利用率低;
内容是哈希键控而非密钥化 MAC,无法防“重嵌并更新头部”的强攻击者;
v1 数据集的独立源图仍有限(414 张校园 + BOSSbase 后扩到 1 万张);弱密度与跨源仍是检出难点,任何新模型都要先做 OOD 测试;
启发式分析输出的是“隐写倾向概率”,不是严格统计意义上的真实概率;
像素域 nsF5 是有损格式的天敌——JPEG 域需要
yccstego那样的 DCT 系数实现(姊妹项目,独立仓库与 PyPI 包;v1.9.0 起经 PyPI 依赖接入本项目主线,见第 1½ 章)。v2/143 维模型对训练分布外的真实 JPEG 干净图曾“过激”,修复依赖把 JPEG 干净样本加入训练——任何模型都要先做 OOD 测试再部署;
SRM 只在同源数据上提升检测,跨异构源反而下降,预处理收益有严格适用范围;
双版本模型各有取舍:143d 更准(8-split 平均 AUC 0.8980、弱档检出 50.0%、真实干净照片 OOD 误报 9.58%)、53d 每一维都能解释但 AUC 约低 0.05(0.8461 / 41.4% / 28.86%);GUI 切换仍在规划,当前用 API 指定 model_path;
项目许可证已改为 Apache-2.0 并含 NOTICE,分发/引用时需保留第三方声明。
11.3 现代信息隐藏与隐写分析地图#
方向 |
代表思想/方法 |
与本科生的距离 |
|---|---|---|
内容自适应嵌入 |
HUGO / WOW / UNIWARD:在纹理复杂处嵌入 |
需要较深最优化背景 |
深度学习隐写 |
编码器-解码器端到端训练隐藏模型 |
可做入门复现 |
深度学习隐写分析 |
SRNet / 大规模 CNN 检测 |
需要大算力与大数据 |
JPEG 域隐写 |
|
姊妹项目(独立仓库与 PyPI 包,v1.9.0 起接入主线) |
可逆/鲁棒水印 |
兼顾不可见性、鲁棒性与容量 |
工程性强,适合就业方向 |
如果你的兴趣被点燃,推荐的下一步:把本手册第 5 章“湿纸”读进原始论文(Fridrich et al.),再用姊妹项目 yccstego 对照学习 JPEG 量化域,最后挑一个 现代算法做文献综述——附录 E 给了具体入口。
11.4 同类工具与本项目定位#
这个领域并非没有实践工具,而是资源分散、上手门槛高。诚实列出几个(非穷举,链接只列长期稳定的,其余按名字检索):
工具 |
语言 |
侧重 |
|---|---|---|
Python |
图像隐写分析工具箱:经典统计攻击 + 特征 + ML 检测 |
|
CONSEAL |
C++ |
面向研究的隐写/隐写分析库,高性能特征提取与嵌入模拟 |
DDE Lab tools |
Java |
高校实验室公开的隐写/隐写分析研究工具集 |
steghide / outguess |
C/C++ |
经典通用隐写工具,与 nsF5 算法族不同支 |
本项目的定位不是替代它们:上述工具面向研究者做检测与攻击实验;本项目做的是交互学习、可视化与可复现实验——把 nsF5 从像素到 DCT 系数端到端实现并配齐教学材料(双语手册、按章 Notebook、交互网站、GUI 算法动画),每一步实验可导出档案、nsf5stego repro 一键重跑。要快速看懂”算法正在发生什么”,用本项目;要做研究级的检测对比,用 Aletheia / CONSEAL 等成熟工具链。
11.5 结语#
12 周前你也许以为隐写就是“把字藏进图片”,现在你应该能讲出:它为什么依赖 载体冗余、为什么直接改 LSB 会留下统计指纹、汉明码如何用最少的改动传递信息、 湿纸编码如何让嵌入“无收缩”,以及机器学习如何诚实地说出“我有多确定”。 这些知识串起来的,不只是 F:\Steganography 这一个项目,而是信息安全、 概率统计与机器学习交汇处的一种思维方式。
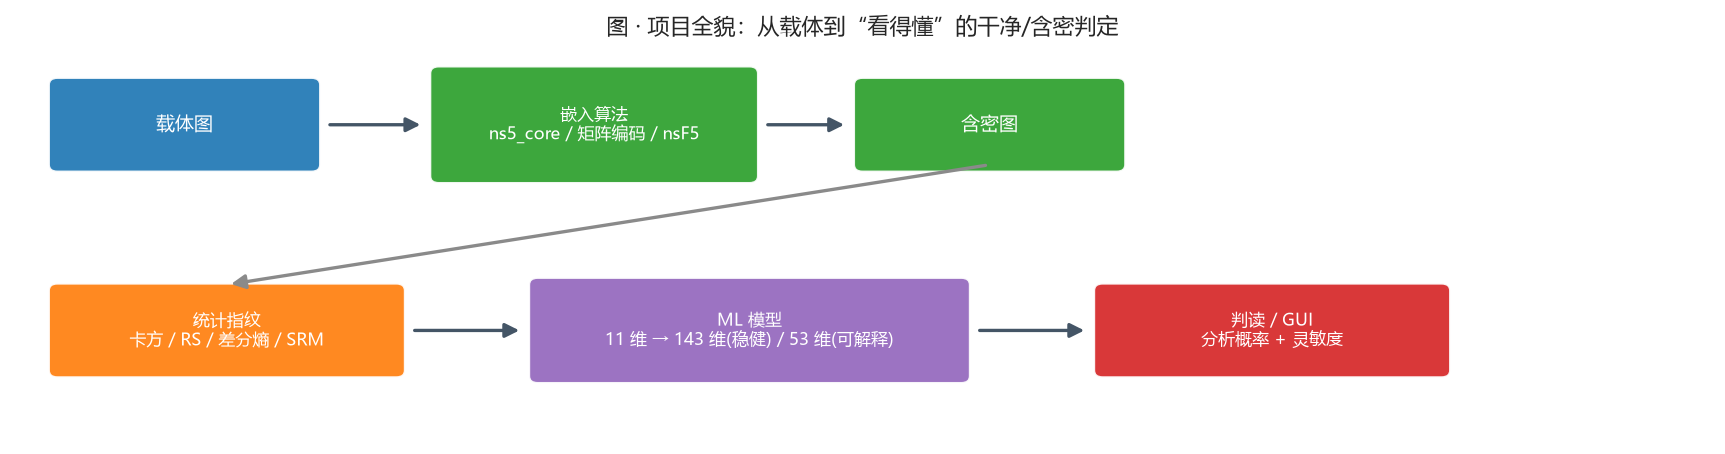
图:把你这个学期搭起来的东西连成一条线——载体 → 嵌入算法 → 含密图 → 统计指纹 → ML 模型 → 判读 / GUI。每一步都能在本手册对应的章节里找到代码与实验。
动手做| 最后做一个收尾练习:不看任何资料,用 500 字向一位同学介绍 “nsF5 为什么比朴素 LSB 更好”。写完后打开 README 对照, 查漏补缺——能写清,才算真正学完。