第 7 章 · 机器学习基础(写给第一次学的人)(第 7–12 周)#
动手做| 本章目标:完整、扎实地学会四件事——一张图怎么变成数字(特征)→ 模型怎么学会判断 → 怎么防止“作弊” → 怎么判断模型好不好。我们从一个完全没接触过机器学习的人也能读懂的角度讲起,配合真实数据生成的图,循序渐进,不赶时间。
7.0 本章路线图:建议怎么学(约 3–6 周)#
如果你有半年到一年的学习周期,完全可以把这一章当成第一次认真学机器学习的入门课,而不仅仅是“看懂项目代码”的速成。建议这样走:
第 1 步(约 1 周):只读 7.1~7.2,建立「数据→特征→标签」的整体印象,能说出自己平时见过哪些“用数字描述一张图”的例子。
第 2 步(约 1 周):读 7.3~7.5,配合 图 7-1/7-2/7-3,理解“画一条线 + 把线变成概率 + 让概率尽量对”。这里不要求会推公式,能看着图复述大意即可。
第 3 步(约 1 周):读 7.6~7.8,重点理解数据泄漏和怎么评估。这是最容易在真实项目里踩坑的地方,也最值得多花时间。
第 4 步(约 1 周):把本章所有代码摘录在你自己电脑上跑一遍(
python src\train_model.py),对着输出确认每行数字的来历。
学习方法建议| 每节末尾都有「想一想」。请把答案写下来,而不是只在心里过一遍——写出来的过程才是真正在学。
7.1 隐写检测,其实就是“猜一张图藏没藏东西”#
换一个角度看问题:一张照片,要么是干净的(标成 0),要么往里面藏过消息(标成 1)。机器学习要做的,就是学会一个判断:给它一张图,尽量猜对是 0 还是 1。
这和“老师把很多带答案的题讲给学生,学生考试时对没见过的题也能做对”是一回事——机器学习不会“背”,它学的是规律。整个监督学习只有四样东西:数据、特征、模型、评估。下面一个个来,每一个都对应到项目代码。
术语小字典| 本章你会反复看到这四个词,先记住它们的“人话版”:
数据 Data:一堆“带答案的例子”。
特征 Feature:把每张图压缩成的一串数字(相当于“用尺子量图”)。
模型 Model:一个“从特征到答案”的判断规则。
评估 Evaluation:判断这个规则到底靠不靠谱。
7.2 一张图怎么变成“数字”:特征与标签#
电脑不认识“图片”,只认识数字。所以第一步是把一张图压缩成一小串数字。项目 v1 版把每张图压成 11 个数字,v1.4 又扩展成 143 个(第 8 章再讲)。这 11 个数字就叫特征向量,它等于“用 11 把尺子去量这张图”。
特征(feature):这 11 个数字。比如“像素差值乱不乱”“亮暗分布对不对”。
标签(label):这张图到底藏没藏,0 = 干净,1 = 含密。
样本(sample):一行 = 一张图,11 个特征数字 + 1 个标签。
数据集长什么样(前几列是特征,label 是答案,photo_id 先别管)
Rm,Sm,Rn,Sn,RS_Gr,RS_Gn,chi2_pvalue,diff_entropy,lsb_diff_entropy,median_prefix_p,chi2_stat,label,photo_id,...
41316,4574,36608,5057,0.56,0.48,0.56,1.99,0.986,2.7e-166,1719.3,0,0,...
40488,4907,35701,5342,0.54,0.46,0.61,2.02,0.989,2.2e-155,1675.9,1,0,...
data/dataset.csv(真实前两行,数值截断显示)
新手提示| 看到
chi2_pvalue、RS_Gn这种名字不用慌,它们就是“第几把尺子量出来的数”。第 8 章会逐个说每把尺子量的是什么。
把表写成数学记号,后面所有公式都用它(别怕,就是“第 i 行、第 j 列”的写法):
样本:一行一个样本,共 \(N\) 个,记 \(i=1,\dots,N\);
特征:第 \(i\) 个样本的 11 个数字记为向量 \(\mathbf{x}_i\);全部行拼成矩阵 \(X\)(\(N\) 行 × 11 列);
标签:\(y_i\in\{0,1\}\),拼成向量 \(\mathbf{y}\)。
7.3 分类 = 画一条线,把两类分开#
有了一堆“带答案的数”,模型要学的是什么?就是在数字空间里画一条线,一边是干净、一边是含密。可以想象成:横轴是“乱的程度”,纵轴是“亮暗是否均匀”,干净图大多在一角,含密图在另一角。模型学的就是那条分界线。
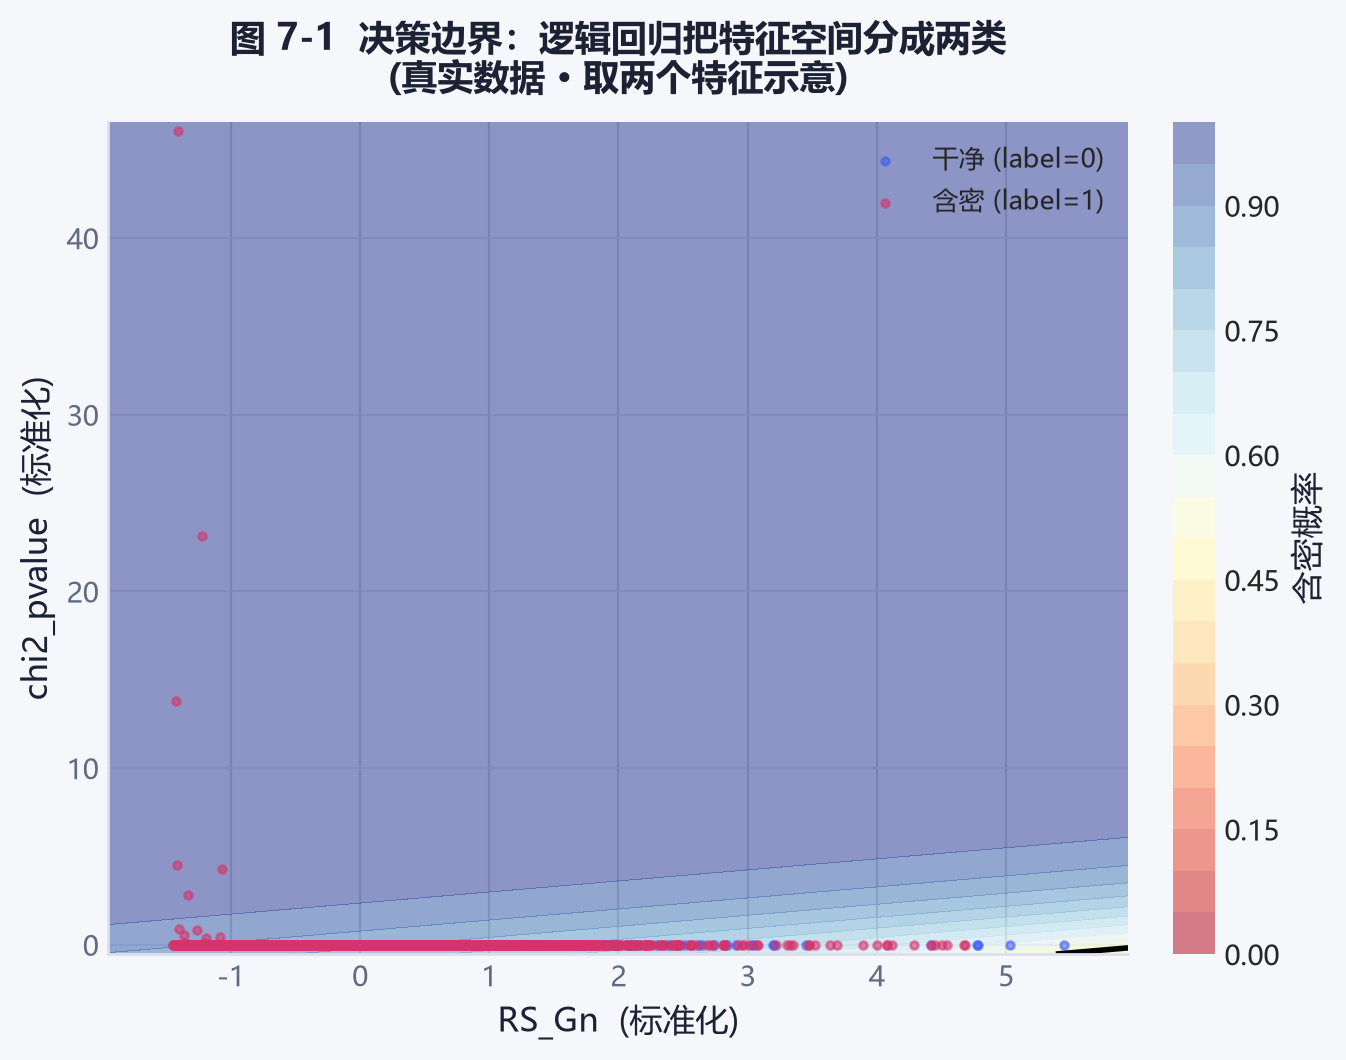
图 7-1(真实数据:用 RS_Gn 与 chi2_pvalue 两个特征,逻辑回归学出的决策边界;蓝=干净,红=含密,色块=模型认为的含密概率)
把这张图看明白,是理解整章的关键。注意几点:
两类不是完全分开的:边界附近蓝点和红点混在一起。说明这两个特征还不足以完美区分,但已经能“大致”分开了。
色块是“概率”:颜色越红,模型越认为含密;越蓝越认为干净。中间那条黑线就是“概率=0.5”的分界。
维度变多也一样:真实模型用 11(或 143)个特征,就是在这 11(或 143)维空间里画一个“超平面”。维度高了画不出来,但道理和这张二维图完全一样。
这条线在数学上就叫线性判别函数,其实就是一个“打分式子”:
别被符号吓到,它就是一个加权求和:
\(x_1,\dots,x_{11}\) 是那 11 个特征数字;
\(w_1,\dots,w_{11}\) 是权重,决定“哪个特征重要、往哪个方向倾斜”。比如某个特征对判断特别有用,它的 \(w\) 就大;
\(b\) 是偏置,相当于把整条线上移或下移一点,用来定位置。
判的时候很简单:\(z\) 大于等于 0 判成含密,小于 0 判成干净。这一整行代码 LogisticRegression 就是在自动找最合适的 \(w\) 和 \(b\)。
想一想| 图 7-1 里,你觉得“RS_Gn”和“chi2_pvalue”哪个对判断更重要?如果只保留一个特征,你会选哪个?—— 这个直觉,会在 7.7 的“特征重要度”图里被验证。
7.4 从“分数”到“概率”:为啥要套一层 sigmoid#
上面那个 \(z\) 是一个可正可负、没有上限的“分数”。但用户更想知道的是一个 0 到 1 之间的概率:“这张图有多大可能是含密”。于是加一层 sigmoid 把分数压到 0~1:
\(z\) 很大(分数高)→ \(\hat p\) 接近 1(多半是含密);
\(z\) 很小 → \(\hat p\) 接近 0(多半干净);
\(z=0\) → 恰好 0.5(一半一半)。
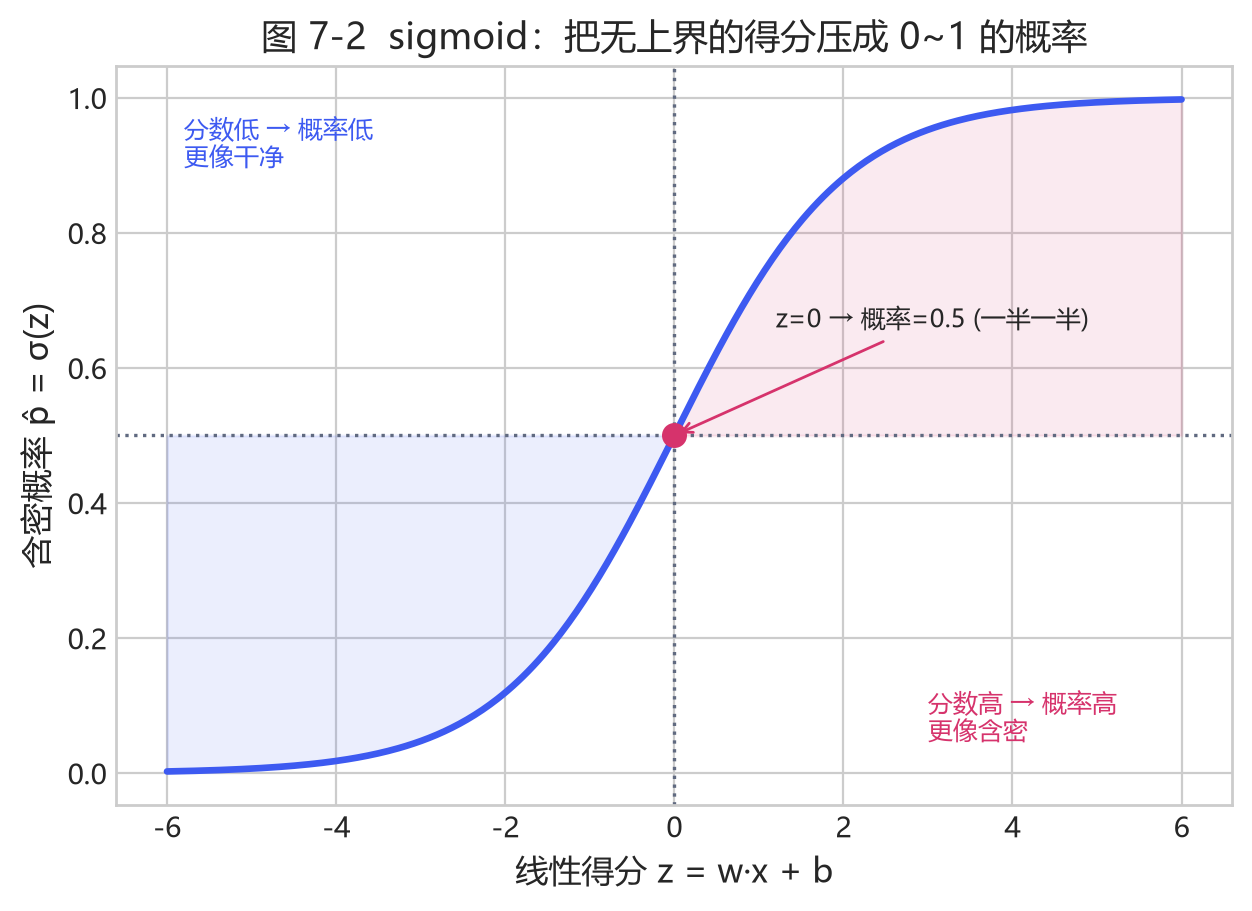
图 7-2(sigmoid 把无上界、可正可负的“得分 z”压缩成 0~1 的“概率”。左半蓝区=更像干净,右半红区=更像含密)
新手提示| 你可以把 sigmoid 想成一个“百分比换算器”:把没边界的分数,换成很好懂的 0%~100%。名字叫“逻辑回归”,其实干的还是“画一条线 + 输出概率”。
7.4.1 为什么不直接用 0/1,而要用“概率”?#
好问题。因为真实世界没有“非黑即白”。图 7-1 里边界附近那些点,模型也不确定。与其让它勉强说“0”或“1”,不如老老实实给出“我有 73% 把握认为含密”。这样:
用户可以自己决定阈值(加到 7.7 讲);
可以评估模型到底有多确定(概率校准);
可以画出 ROC / AUC 这种与阈值无关的指标(7.7.1)。
术语小字典| 输出概率的分类器叫软分类(soft classification);直接输出 0/1 的叫硬分类(hard classification)。逻辑回归是软分类,这也是它能算 AUC(曲线下面积,衡量模型把含密排在干净前面的能力,越大越好,详见 7.7.1)的前提。
对照项目代码——src/train_model.py:
def lr(seed=0): return make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000, C=0.1, random_state=seed))
代码 |
人话解释 |
|---|---|
|
先把每个特征调成“差不多大”,免得某个数字太大把分界线带偏(见 7.4.2) |
|
就是上面“画线 + sigmoid 输出概率”那套,自动找 \(w\)、\(b\) |
|
最多调整 2000 次,防止它没算完就停 |
|
一个“让它别太用力记答案”的旋钮(正则化,见 7.5.2) |
想了解再点| 为什么先标准化?因为“卡方统计量”可能是几千,“Gn”却只有 0~1。权重对它俩一样敏感的话,梯度会拼命去迁就那个大数字,线就被带歪了。标准化的公式是
x'=(x-μ)/σ,把每个特征变成“均值 0、标准差 1”,大家就公平了。注意 μ、σ 只能从训练集算,别把测试集偷偷用进去。
7.5 模型怎么“学会”:损失与训练#
“学会”到底在干嘛?就是不断调整 \(w\) 和 \(b\),让输出概率尽量接近正确答案。怎么衡量“接近”呢?用一个损失(loss)——你可以理解成“猜错要扣多少分”。经典做法是交叉熵(log loss):
大白话:当正确答案是 1(藏了)时,只看 \(\hat p_i\)——它越接近 1,扣分越少;当正确答案是 0 时,只看 \(1-\hat p_i\)——它越接近 0,扣分越少。猜得越离谱,扣得越狠。
那怎么让扣分变少?一点点试:算一下“往哪个方向微调、扣分降得最快”,就沿那个方向挪一小步。这叫梯度下降:
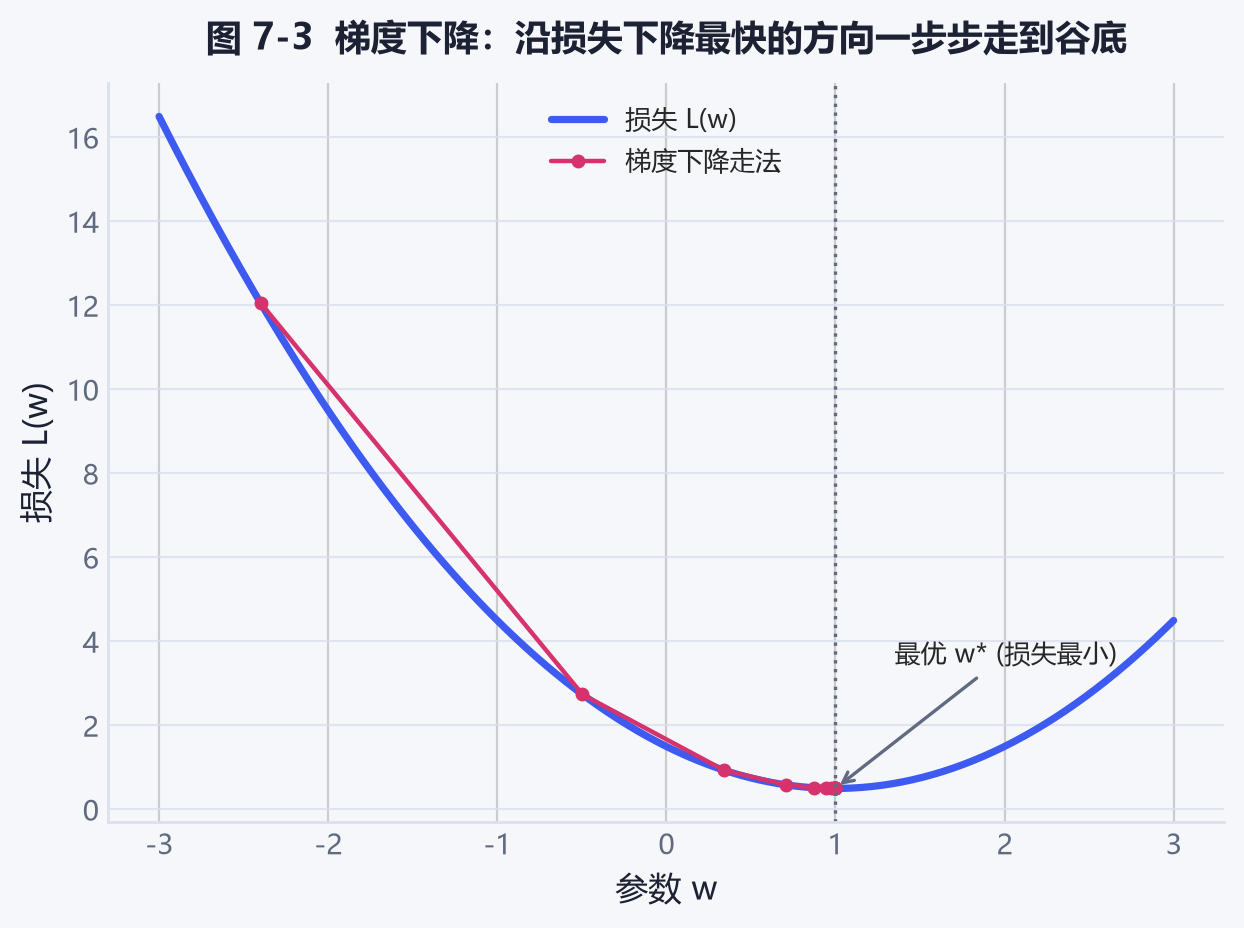
图 7-3(一个简单的“损失 vs 参数”曲线。红色阶梯就是梯度下降:从左边出发,一步步走到谷底——损失最小的那个 \(w^*\)。蓝线是损失函数,谷底就是最优参数)
新手提示| 你完全不用会推导数。只要记住三句话:损失 = 模型错得有多离谱;训练 = 找参数让损失最小;梯度下降 = 顺着“让损失变小最快的方向”一点点挪。这些 scikit-learn 都帮你封装好了。
7.5.1 从“一步到位”到“一步步走”,为什么非得这么绕?#
理论上,逻辑回归的损失是“凸函数”,可以一步算出最优解。但真实项目里:
数据量一大,直接求逆矩阵慢且不稳定;
我们要的是能把问题推广到很多模型(树、神经网络)的通用方法;
梯度下降是任何把“最小化损失”当成目标的模型的共同引擎。
所以理解梯度下降,等于同时理解了线性模型、树模型、甚至神经网络的“训练”是怎么一回事。这就是它的价值。
7.5.2 一个“防过头”的旋钮:C 与正则化#
如果特征之间高度相关或样本很少,模型可能把权重 \(w\) 调得巨大,去死记硬背训练数据——这是过拟合的征兆。防的办法之一是给损失加一项“惩罚”,要求权重别太大(L2 正则):
scikit-learn 用的是逆正则化参数 \(C=1/\lambda\):
C=0.1→ \(\lambda=10\),强正则,权重被狠狠压缩,模型偏保守;C=1.0→ \(\lambda=1\),中等;C越大正则越弱。
回到项目看代码|
train_model.py里基模型用LogisticRegression(C=0.1)(想让基模型“克制、别乱记”),而堆叠器的 meta 学习器用C=1.0(放松一点,让它自由综合)。同一个类,两个 \(C\),体现“基模型要稳、meta 学习器要灵”的取舍。
7.6 怎么不让模型“作弊”:交叉验证与分组#
模型在见过的题上拿高分很容易,真正要看的是没见过的题。如果模型把训练样本硬背下来,遇到新题就崩——这叫过拟合。
防过拟合的标准办法是交叉验证:把数据切成几份,轮流拿一份当“小考”,其他当“复习”。但这里有个特别容易踩的坑。
避坑提醒| 同一张照片有 7 个变体(1 个干净 + 6 个藏过东西),它们互相太像了。如果随便切,训练里可能会混进某张测试照片的“亲兄弟”,等于提前把答案告诉了模型——这叫数据泄漏,分数会虚高到离谱。项目的做法是按
photo_id分组:同一张照片的所有变体,要么全部进训练、要么全部进测试,绝不分开。
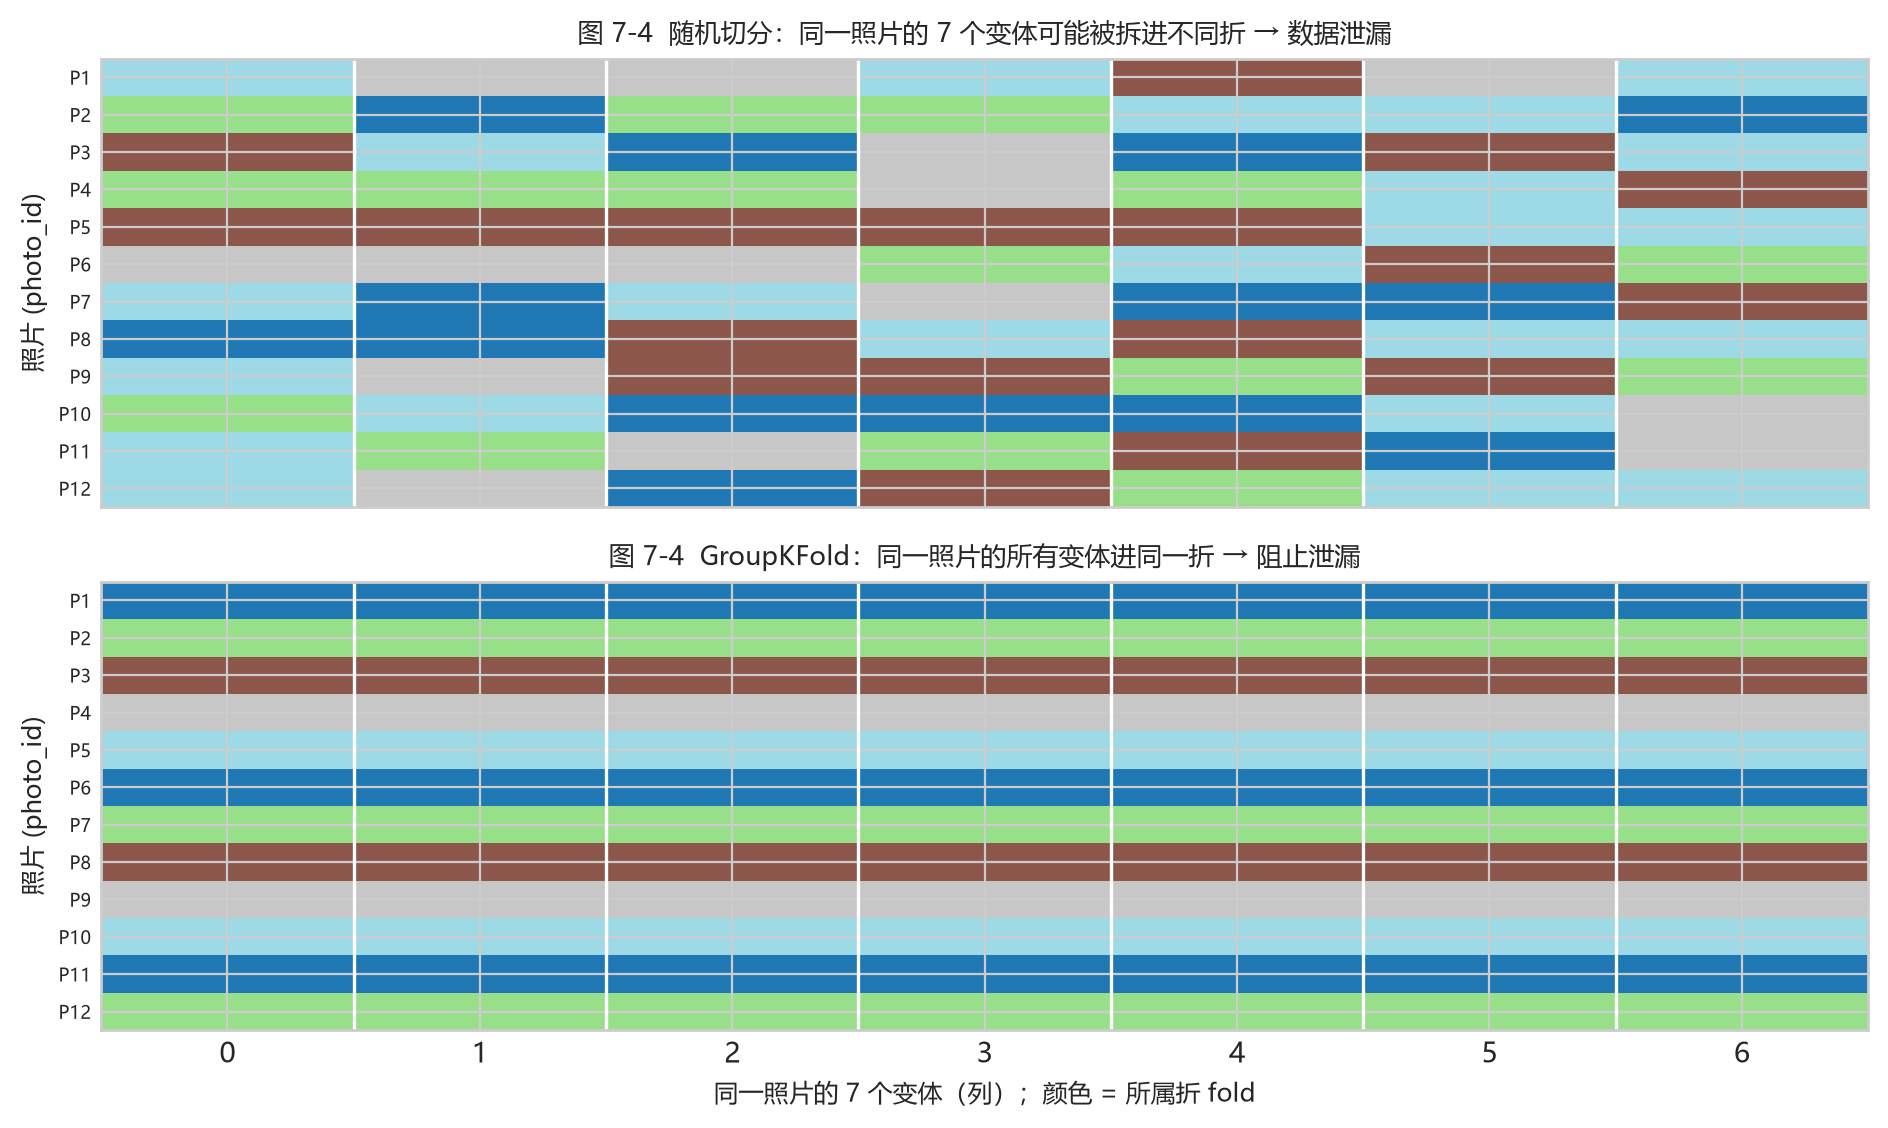
图 7-4(示意:每个 P 是一张照片,一行有 7 个变体。上排“随机切分”会把同一张照片的 7 个变体拆进不同折——漏题;下排“GroupKFold”让同一张照片的 7 个变体进同一折——诚实)
对照代码——src/train_model.py::cv_oof() 的核心:
from sklearn.model_selection import GroupKFold
gkf = GroupKFold(n_splits=5)
for tr, va in gkf.split(X, y, groups):   # groups = photo_id,按照片分组再切
    clf.fit(X[tr], y[tr])
    p = clf.predict_proba(X[va])[:, 1]   # 只在这折“小考”上打分
关键就是 groups 这个参数。它告诉切分器:“同一组的样本不能拆散”。换成普通的 KFold 就会把同一张照片的“亲兄弟”拆到两边,分数就作弊了。
想一想| 为什么“同一张照片的 7 个变体”算不上一份独立样本?试着设计一个最小例子:假如只有 10 张照片,随机切分有多大概率把某张照片的“亲兄弟”拆到训练/测试两边?这样的“泄漏”,对分数影响有多大?(提示:想想 7.7.1 的 0.5 随机线)
7.7 评估:别只盯“准确率”#
模型输出的是概率,得定一个阈值才能说 0 还是 1。评估一套指标,先看混淆矩阵:
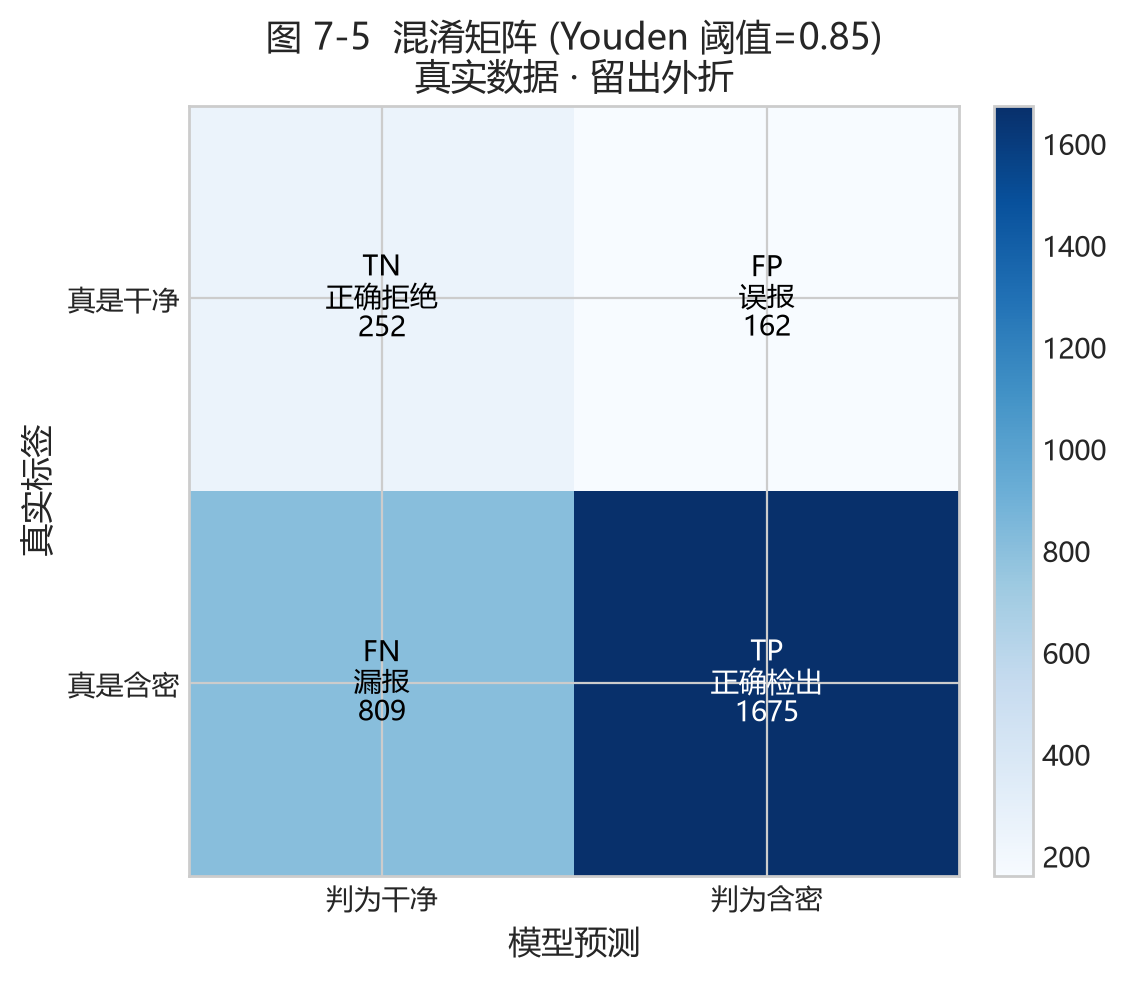
图 7-5(真实数据在 Youden 阈值下的混淆矩阵:TN=正确拒绝、FP=误报、FN=漏报、TP=正确检出。数字是真实样本数)
由这四个数(TN、FP、FN、TP)定义的常用指标:
准确率:整体猜对的比例。坑:数据里含密多、干净少,模型全部判“含密”,准确率照样很高,但把所有干净图都冤枉了。
精确率:被判成含密的人里,有多少是真的。
召回率:真正的含密图,抓到了多少。
F1:精确率和召回率的折中。
指标 |
回答的问题 |
直觉 |
|---|---|---|
准确率 |
整体猜对多少 |
不平衡时骗人 |
精确率 |
判为含密里真含密 |
误报低→精确率高 |
召回率 |
真含密里抓到多少 |
漏报低→召回率高 |
F1 |
两者都要时 |
折中 |
ROC / AUC |
排序能力强不强、跟阈值无关 |
0.5 等于瞎猜 |
7.7.1 ROC 曲线与 AUC:只看“能不能把含密排前面”#
核心思想:一个好模型,应该把含密的图排在干净图前面。把阈值从高到低扫一遍,就能画出一条 ROC 曲线,横轴是“误报率”,纵轴是“检出率”。曲线越靠近左上角越好。
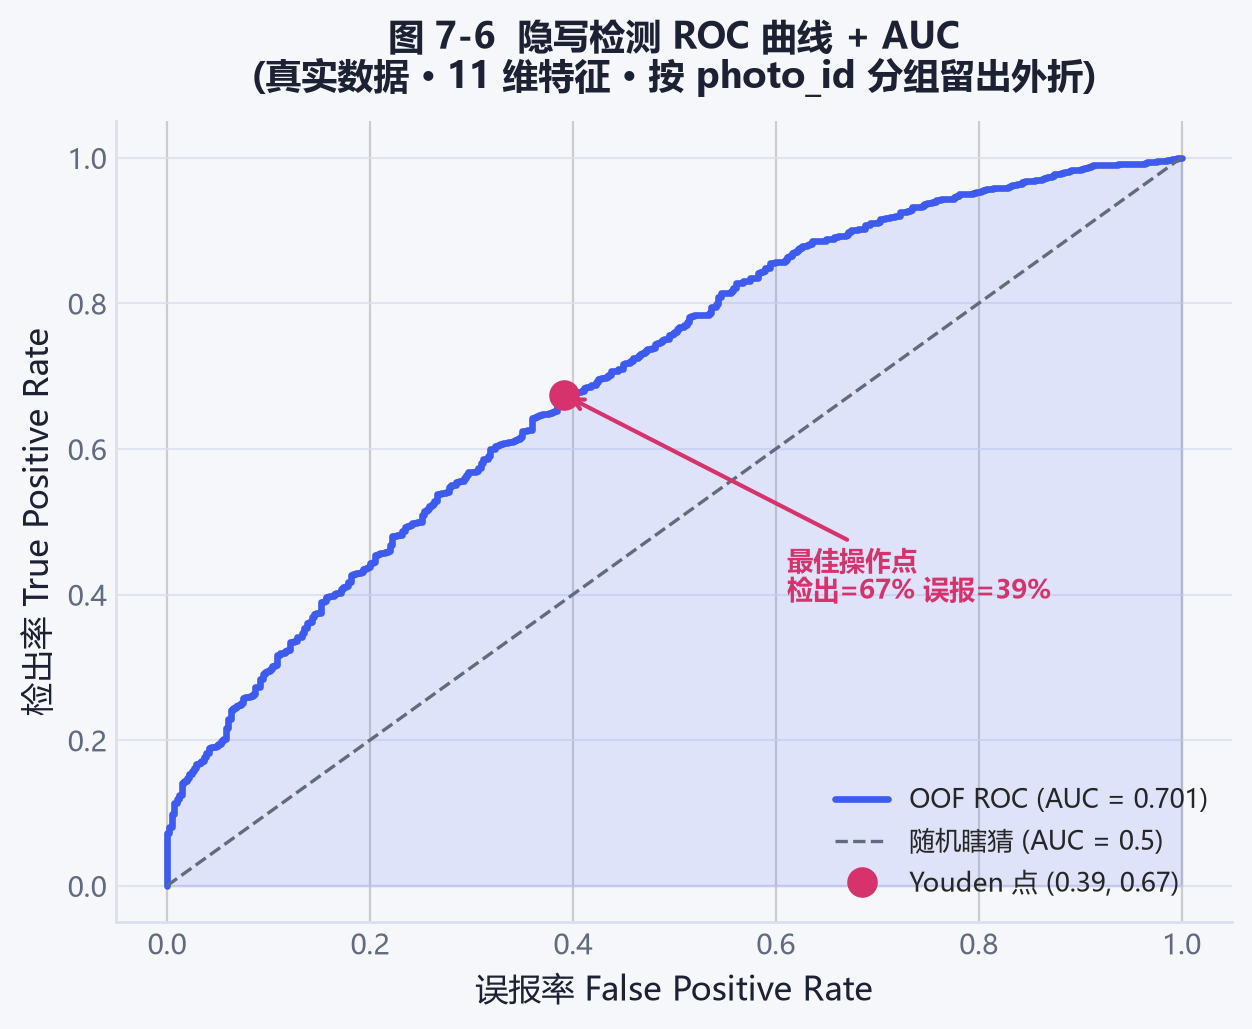
图 7-6(真实数据生成的 OOF ROC 曲线:AUC≈0.70。红色阴影区域就是 AUC——“随机抽一张含密图、一张干净图,模型把含密图排在前面”的概率。红色圆点=Youden 最佳操作点)
AUC 就是曲线下面积:0.5 是瞎猜(对角虚线),1.0 是完美排序。0.7 意味着“多数时候能把含密排在干净前面”,但还不够好——这正对应弱密度难检出的现实。
关键点| AUC 与阈值无关!不管你把阈值定在 0.5 还是 0.7,AUC 都不变。因为 AUC 只关心“排序”,不关心“具体在哪个点切”。这在下图(7-7)能直接看出来。
7.7.2 阈值怎么选:ROC 上的“操作点”#
虽然 AUC 与阈值无关,但真正部署时你必须选一个阈值。选高→保守(误报少、漏报多);选低→激进(检出多、误报多)。看下图就一目了然。
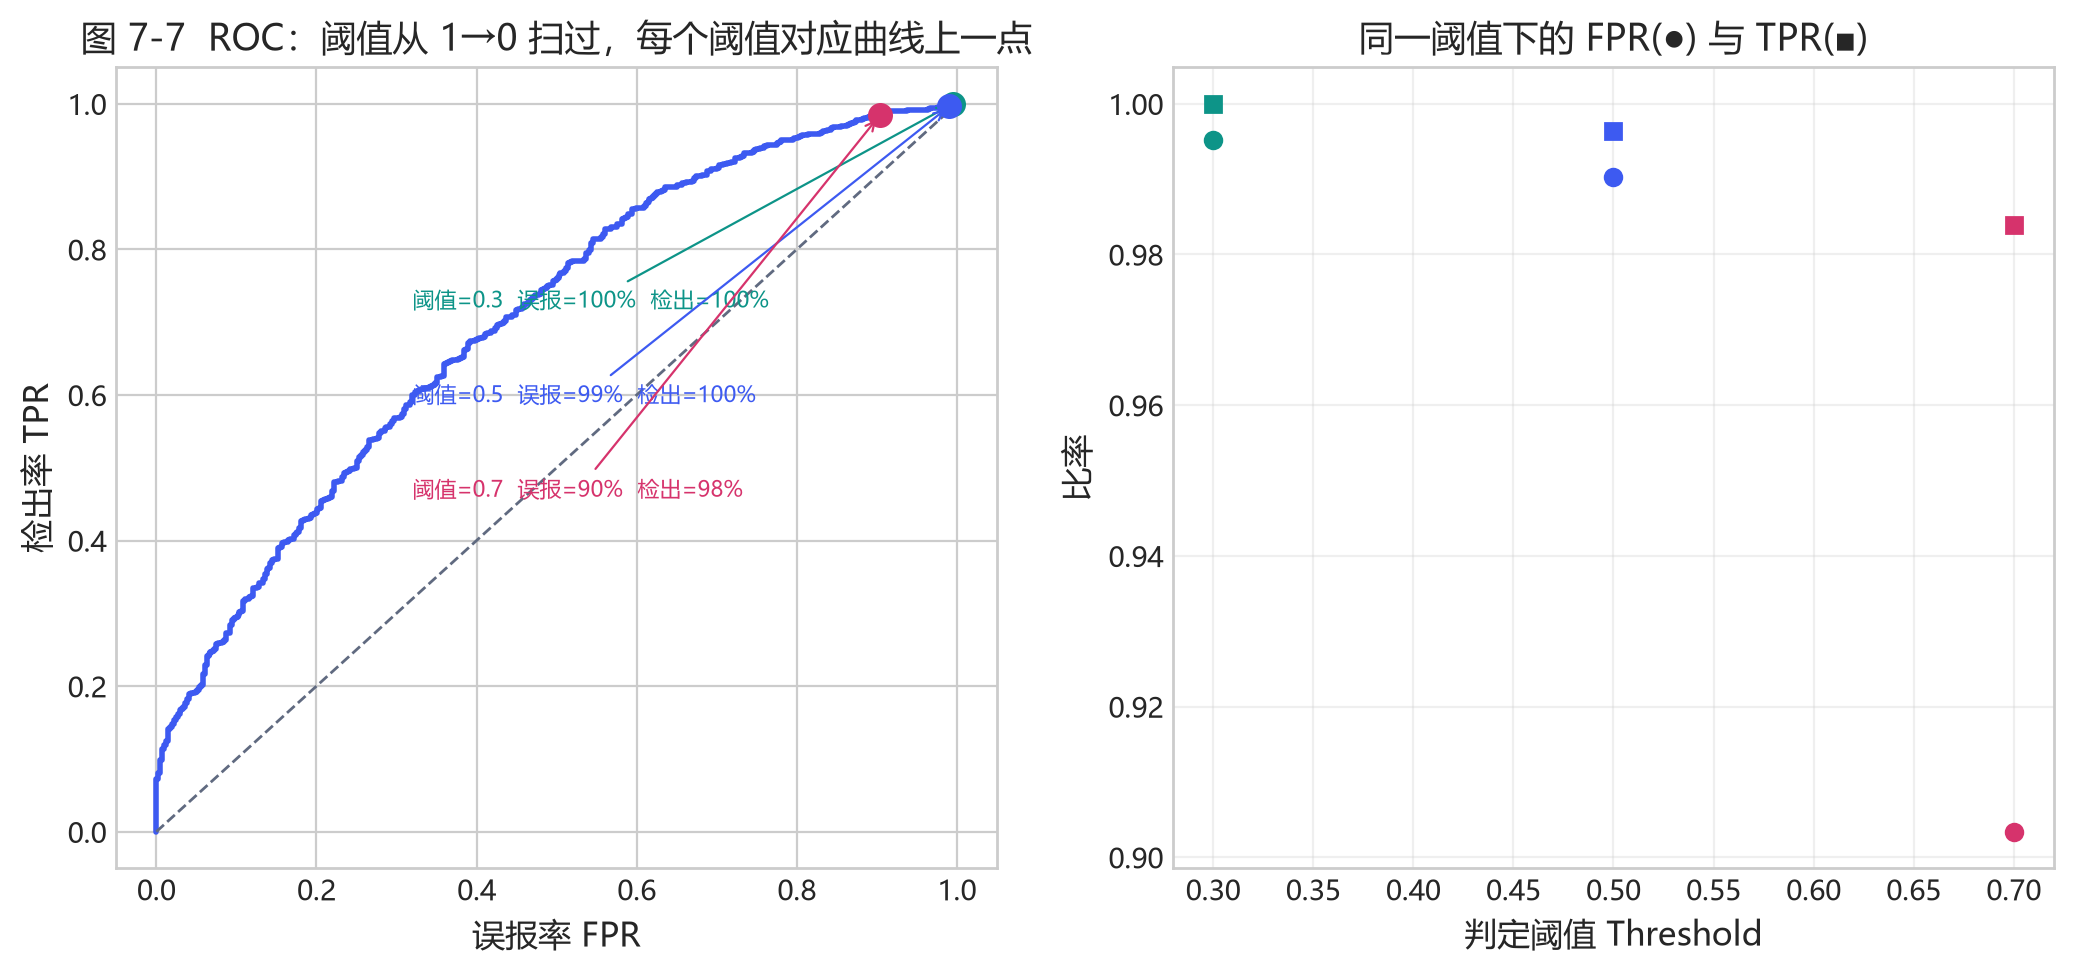
图 7-7(同一组测试,左图:阈值分别取 0.3/0.5/0.7 时在 ROC 上的三个点;右图:同一阈值下“检出率 TPR(■)”和“误报率 FPR(●)”怎么变。阈值越低,检出越高但误报也越高——这就是一对不可避免的矛盾)
回到项目代码|
train_model.py里用 Youden 准则自动选阈值,就是找“检出率 − 误报率”最大的那个点(离随机线最远的点),再另算一个“低误报”阈值(误报率≤10%)供严格档使用:
from sklearn.metrics import roc_curve
fpr, tpr, th = roc_curve(y_true, proba)
j = tpr - fpr             # Youden J = 检出率 - 误报率
best = float(th[np.argmax(j)])   # 让 J 最大的阈值,就是离随机线最远的点
7.7.3 为什么“准确率”在这里会骗人#
想象 2898 个样本中 2484 个是含密:只要模型全部判含密,准确率就是 \(2484/2898\approx85.7\%\),看起来很高,但它是把 414 张干净图全误报了。所以准确率在类别不平衡时没意义,要看 AUC、召回率、F1 这类指标。
我特别画了一张图,把“阈值怎么影响各项指标”完整展示出来,请看:
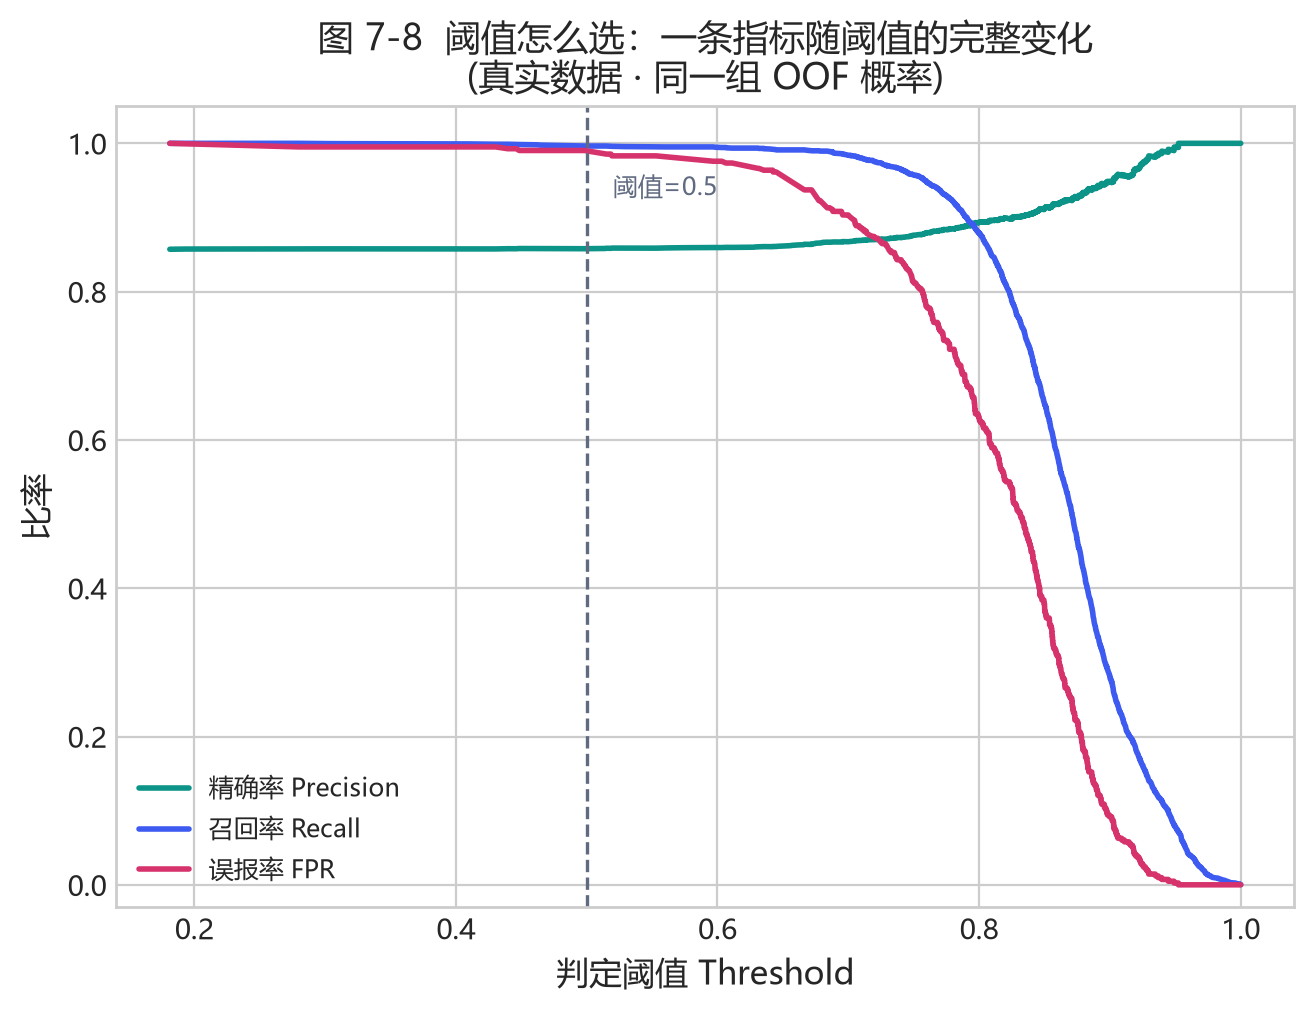
图 7-8(真实数据:随阈值从 1 降到 0,精确率(绿)、召回率(蓝)、误报率(红)的变化。你选的阈值,就是一个“操作点”——在这里做取舍)
读图要点:
阈值很低时:召回率高(几乎都抓到),但精确率低、误报率高(误杀很多干净图);
阈值很高时:精确率高(判为含密的基本都是真的),但召回率低(漏掉很多);
中间某处,你会选一个符合自己需求的“折中点”。
动手做| 运行一次
python src\train_model.py。不用看懂全部,先找三行:CV-AUC、测试集 AUC、低误报点检出率。第 8 章会逐行解释。
7.8 进阶:项目还做了两个“加分项”(看得懂就行)#
train_model.py 里还有两件事,第一次学知道个大概即可:
概率校准:逻辑回归常“过分自信”(该 0.3 的说成 0.95)。项目加了一层校准,让概率更接近真实比例,这样定阈值才有意义。
堆叠(stacking):它不用一个模型打天下,而是把“逻辑回归、随机森林、梯度提升、XGBoost”这 4 个模型的答案都拿出来,再让一个小模型(逻辑回归)学“该听谁的”。
新手提示| 堆叠有点像“评委团”:每个评委(基模型)先独立打分,再由一个“组长”(meta 学习器)综合定结论。它不挑单个最好,而是把几种思路的优势合并。第 8 章的 图 8-4 会把这四个模型横向比一比,你就知道为什么它们能“互补”了。
7.9 小结与自我检查#
一句话总结本章:机器学习 = 用「数据 → 特征 → 模型 → 评估」,把“一张图藏没藏东西”变成一个可判断、可评估、可解释的过程。
监督学习 = 用“带答案的样本”学一个从特征到答案的判断;
分类 = 用一条分界线把两类分开,逻辑回归 = 画线 + sigmoid 输出概率(图 7-1、7-2);
损失 = 猜错扣多少分;训练 = 让损失变小;梯度下降 = 一点点朝下走(图 7-3);
同源样本别随便切分,
GroupKFold按photo_id分组才是诚实的(图 7-4);准确率在不平衡时失真,看 AUC / 精确率 / 召回率;阈值决定“严一点还是松一点”(图 7-5 ~ 7-8)。
想一想| 如果一篇论文说“隐写检测 AUC=0.95”,但没说数据是怎么切的,你会先怀疑什么?写下来——这就是你评估一切机器学习实验的起点。再想深一层:它有没有做概率校准?它的阈值是怎么选的?这些细节会不会也在“挑”一个好看的结果?
动手做| 把图 7-6、7-8 看懂后,试着回答:如果领导要求“误报必须低于 5%”,你应该把阈值往高还是往低调?代价是什么?