第 3 章 · LSB 隐写与它的统计“指纹”(第 3–4 周)#
动手做| 本章目标:亲手完成一次“藏进去→检测出来”的最小闭环;理解卡方检验与 RS 分析各自抓住了什么;看懂 steganalysis.py 的判读逻辑。我们先用真实载体(img/cover.png)直观看到 LSB 改动有多“隐蔽”,再看统计如何戳穿它。
3.1 加密 vs 隐写:先回答第一个问题#
维度 |
加密(Encryption) |
隐写(Steganography) |
|---|---|---|
保护对象 |
消息内容:没有密钥就读不懂 |
通信行为:别人看不出有秘密 |
可见性 |
密文明显“不像正常数据” |
载体看起来完全正常 |
典型场景 |
传输密码、证书、加密文件 |
隐蔽信道、版权水印、取证研究 |
相互关系 |
可先加密再隐写(强烈推荐) |
隐写隐藏的是“秘密存在”这一事实 |
新手提示| 一句口诀:**加密保护“内容”,隐写保护“存在”。**专业隐写系统通常两者都用:先把消息加密,再把密文藏进载体。加密后密文近似随机,反而更不容易在统计上露馅。
3.2 最小可运行的 LSB 隐写#
最朴素的隐写叫 LSB 替换(LSB replacement):把秘密比特串逐位写进像素的 LSB。灰度图有 M×N 个像素,就能藏 M×N 个比特。
教科书版最小 LSB(仅用于理解;项目实际用的是第 4–5 章的矩阵编码)
import numpy as np

def text_to_bits(s):
    raw = s.encode("ascii")
    # 16 bit 长度头 + 每个字符 8 bit
    head = [(len(raw) >> i) & 1 for i in range(16)]
    body = np.unpackbits(np.frombuffer(raw, np.uint8))
    return np.concatenate([head, body]).astype(np.uint8)

def lsb_embed(cover, bits):
    flat = cover.ravel().copy()
    k = min(len(bits), flat.size)
    flat[:k] = (flat[:k] & 0xFE) | bits[:k]   # 清最低位再写入
    return flat.reshape(cover.shape)

def lsb_extract(stego, nbytes):
    flat = stego.ravel() & 1
    return bytes(np.packbits(flat[16:16 + nbytes*8]))
避坑提醒| 有损格式是 LSB 的天敌。 PNG/BMP 无损保存,位面不会变;JPEG 有损压缩会把 LSB 打得面目全非。所以项目默认保存 PNG,而 JPEG 域隐写需要另做一套(姊妹项目
yccstego走的正是量化 DCT 系数路线;它是独立仓库与 PyPI 包,不在本仓库内)。
为什么消息开头要先放 16 bit 长度头?因为解码端必须知道“读多少字节”才能还原消息。项目 src/ns5_core.py 的 encode_string() 正是先写 16 位小端长度、再写 UTF-8 字节——你在 3.2 的例子里已经把这个结构复制了一遍。
3.2.1 先亲眼看一眼:LSB 改动到底有多“隐蔽”#
用项目的演示载体 img/cover.png 做一次真实的 LSB 替换(藏随机比特),看有 ~25% 像素的 LSB 被改写后,图片变成什么样:
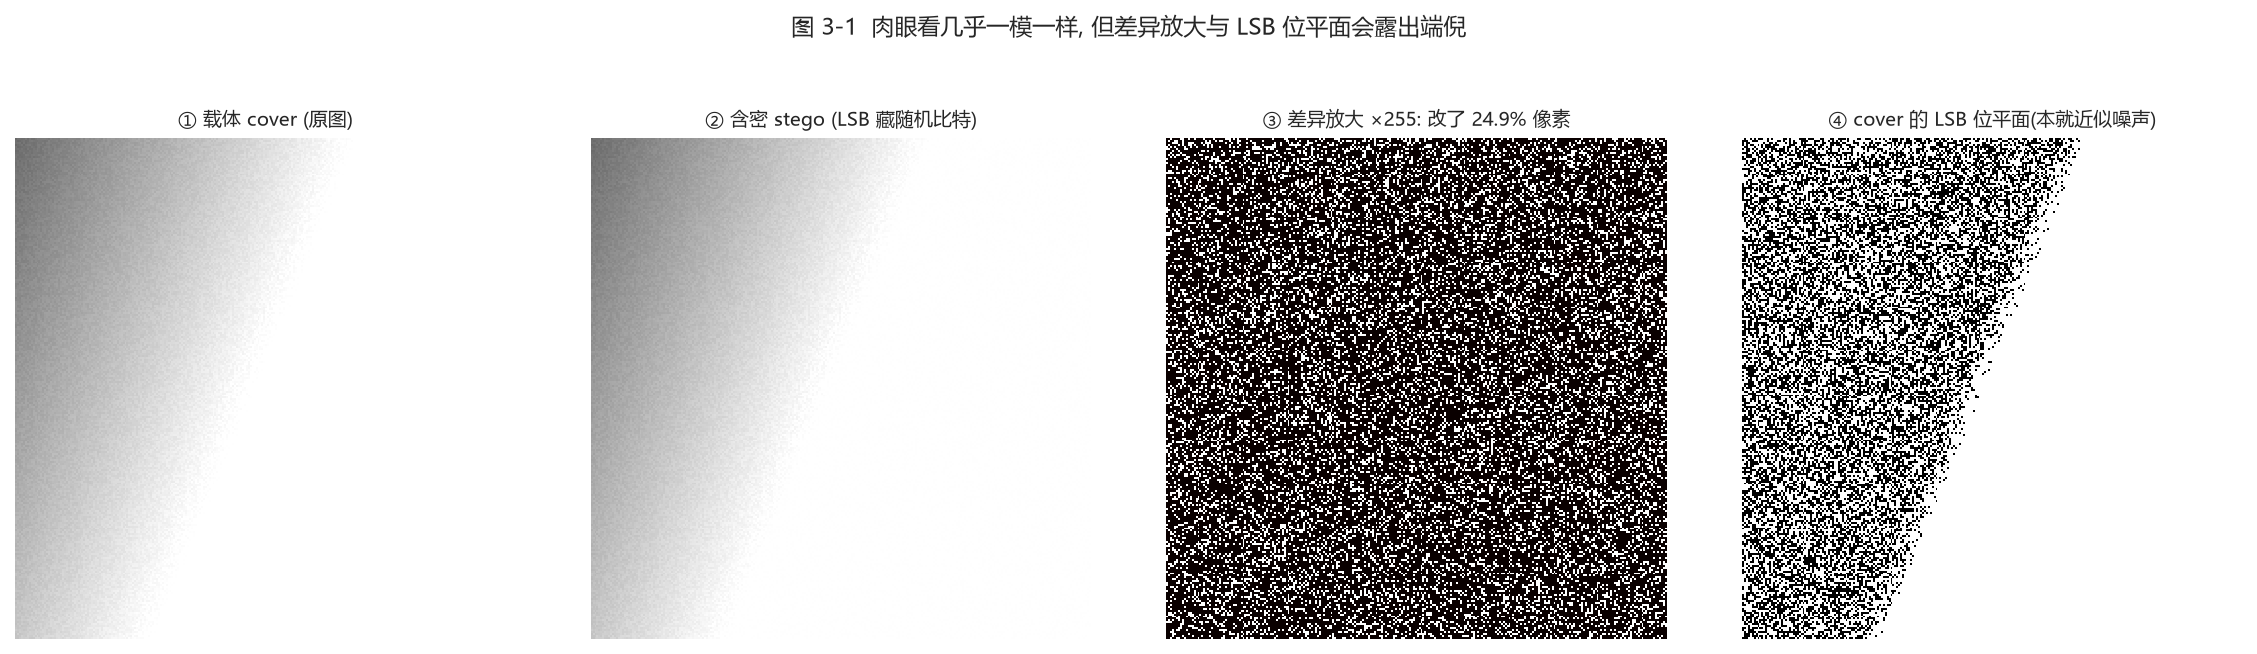
图 3-1(真实数据:① 载体 img/cover.png;② 用朴素 LSB 藏入随机比特后的含密图;③ 把“|载体−含密|”放大 255 倍,才看清改动遍布全图;④ 载体本身的 LSB 位平面——本就近似噪声)
读图要点:
① vs ② 肉眼几乎无差别——这正是 LSB 隐写的“隐蔽”所在;
③ 差异放大 ×255 后,才能看到散落全图的噪点,这就是“被改动的像素位置”;
④ cover 的 LSB 位平面本就是细碎噪声——所以往里面再藏随机比特,直方图/肉眼都难以察觉。
3.2.2 像素级:到底改了多少、改成什么#
再放大到一小块真实像素值,看嵌入前后每个像素的变化:
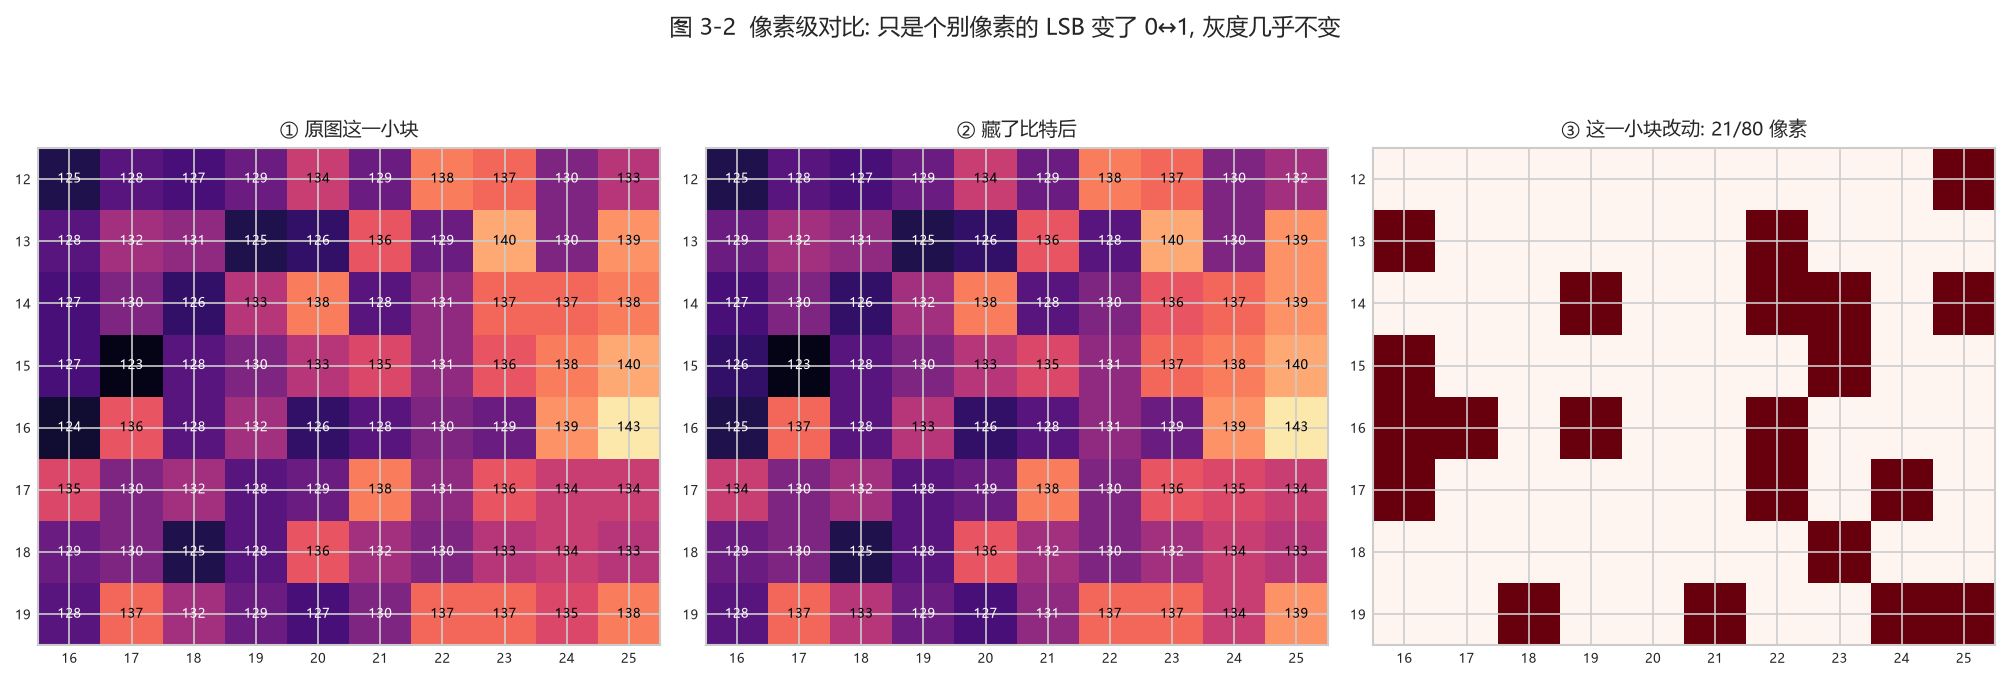
图 3-2(真实数据:①/② 分别是同一小块区域 嵌入前/后 的灰度值;③ 标出被改的 21/80 个像素。注意每处改动只差 1——因为只是 LSB 在 0↔1 之间翻转)
读图要点:
每个被改的像素,值只 ±1(如 127→128、135→134),因为变的是最低位;
人眼对 1 级灰度差完全无感——这就是“视觉冗余”;
但正是这种“把奇偶拉平”的改动,给统计检测(3.3 卡方、3.4 RS)留下了可测的指纹。
新手提示| 记住两个词:视觉冗余(人眼看不出)与统计冗余(检测器看得出)。LSB 隐写利用了前者,却恰恰破坏了后者——这成为所有统计检测的突破口。
3.3 为什么会露馅:卡方检验#
自然图像里,相邻灰度 2i 与 2i+1(例如 100 与 101)出现的次数通常不相等。LSB 替换会强制把偶数与奇数“配对拉平”:当某像素从 2i 改成 2i+1 或反过来,两个灰度的频数会趋向均衡。Westfeld 的卡方检验做的就是这件事:
统计整张图的 256 级灰度直方图,按相邻对 (0,1)、(2,3)、…、(254,255) 配对;
假设“已嵌入”,则每对的两个频数应近似相等,期望值取对之和的一半;
计算统计量 Σ(观测−期望)²/期望(只统计频数和大于 0 的灰度对);
把统计量换算成 p 值:p 高表示“观测与均匀假设吻合”→ 疑似 LSB 随机化;
项目还会把图切成 20 个前缀段分别计算 p 值,取中位数,得到更稳的判据。
注意 p 值的含义容易反:这里 p 越大越可疑,因为它在说“如果 LSB 已被完全随机化,看到这种分布的几率很大”——而干净的平滑图通常不会这么均匀。
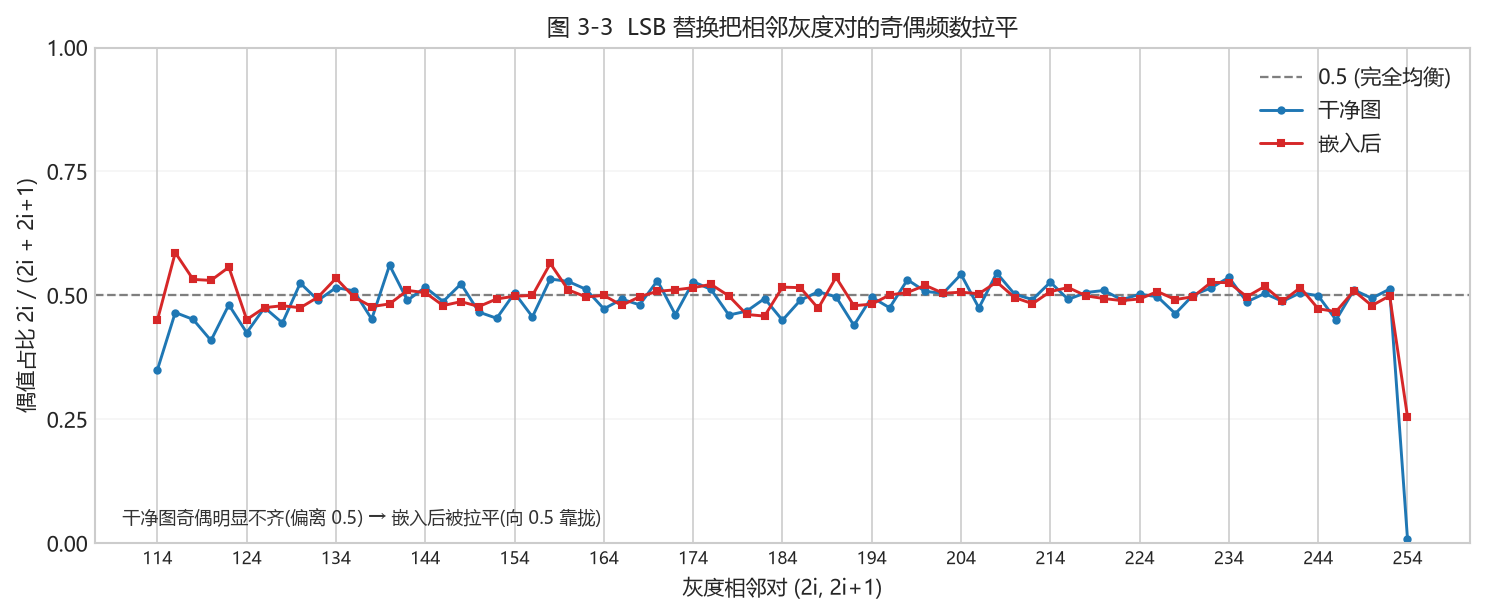
上图对比了干净图与 LSB 嵌入后、每个相邻灰度对 (2i, 2i+1) 里偶值所占的比例:干净图(蓝)明显偏离 0.5(奇偶频数不齐);嵌入后(粉)被“拉平”,向 0.5 靠拢。这正是卡方检验要抓的信号——越均衡,p 值越高,越可疑。
避坑提醒| 天然噪声图会骗过卡方检验。 数码照片本身 LSB 就接近随机,卡方 p 天然很高。所以项目引入了“内容本底随机度”修正:先用灰度差分熵估计图像本身有多‘随机’,再决定是否把高 p 当作嵌入证据。这是把启发式做成可用的关键工程细节。
3.4 RS 分析:LSB 的“结构塌缩”#
Fridrich 等人的 RS 分析换了一个角度:不比较灰度对频数,而是观察 LSB 位面的空间结构。做法是把像素流切成 4 像素一组,定义一个平滑度判别式 f(组内相邻差绝对值之和),再分别用“正掩码”与“负掩码”翻转组内部分像素的 LSB,统计翻转后 f 变大(规则 R)还是变小(奇异 S)的组数。
干净的自然图像在负掩码下有明显的“常规倾向”,常用量 Gn = (Rn−Sn)/N 显著为正(项目里干净平滑图常在 0.3~0.7)。LSB 替换让位面随机化后,这个结构“塌缩”,Gn 明显下降。项目同时输出 Gr、估计嵌入率等,共同组成“RS 证据”。
项目 steganalysis.py 中 RS 的核心逻辑(伪代码,仅示意分组与统计思想)
groups = flat[:m].reshape(-1, 4)        # 每 4 像素一组
fg = np.abs(np.diff(groups, axis=1)).sum(axis=1)   # 原平滑度 f
pos = (groups ^ np.array([0,1,1,0])) & 0xFF        # +M 翻转
neg = (groups ^ np.array([1,0,0,1])) & 0xFF        # -M 翻转
Rm = (f(pos) > fg).sum();  Sm = (f(pos) < fg).sum()
Rn = (f(neg) > fg).sum();  Sn = (f(neg) < fg).sum()
Gn = (Rn - Sn) / n          # 干净图明显为正,随机化后≈0
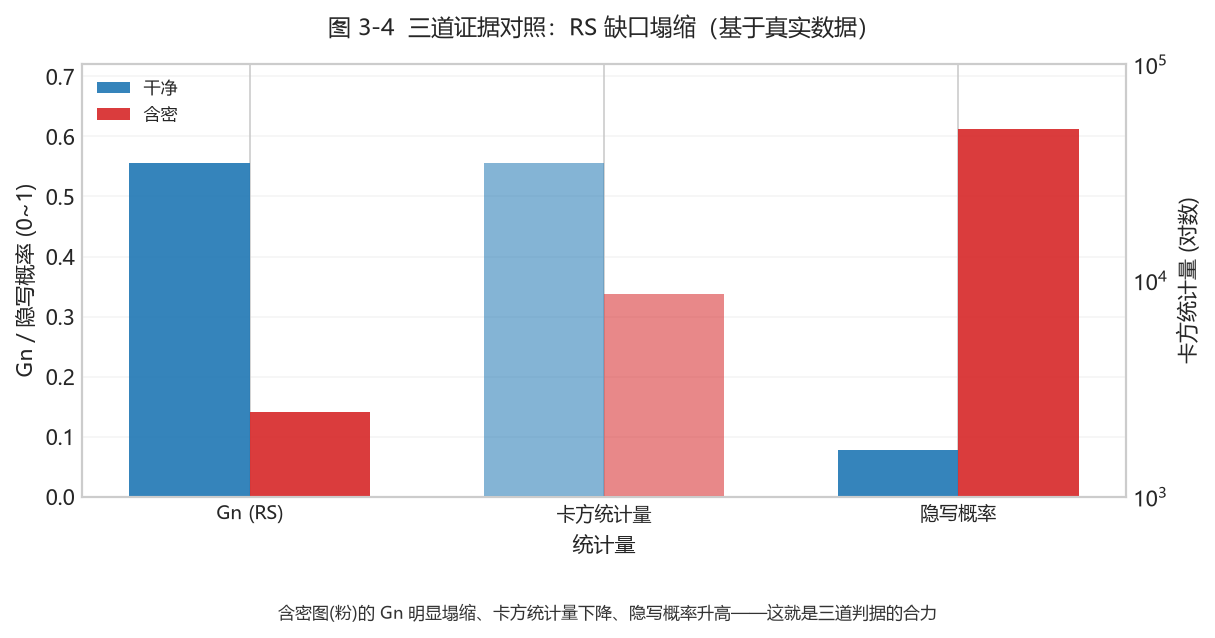
上图用项目真实统计量对比了干净图(蓝)与含密图(粉):RS 缺口 Gn 从明显为正(结构)塌缩、卡方统计量下降(奇偶被抹平)、ML 含密概率上升。LSB 嵌入把位面的“秩序”破坏掉了——这组柱状图就是 RS/卡方/ML 三道证据的直观对照。
3.5 项目的综合判读:analyze()#
src/steganalysis.py 的 analyze(image, sensitivity=...) 并不只看一个统计量,而是组合四路信号:
卡方中位 p 值(判断灰度对是否被拉平);
RS 塌缩幅度(Gn 相对内容自适应基线的下降比例);
灰度差分熵与 LSB 差分熵(判断“随机”是不是图像本底自带);
前缀 p 值序列(观察随机化是局部还是整体)。
三档灵敏度(严格/均衡/宽松)调整“可能/高度可能”的判定阈值与概率牵引系数,本质是在误报与漏报之间选择操作点。
回到第 7 章看全貌| 第 7 章会把这套启发式升级成“特征 + 监督分类器”,并画出更完整的 ROC / AUC(图 7-6)与特征分布(图 8-1/8-2)。
3.6 动手实验:藏一句英文,再抓它出来#
利用项目真实 API:嵌入 → 保存 → 分析(可在 Jupyter 中逐段执行)
import sys; sys.path.insert(0, "src")
import numpy as np
import image_io as IO
from ns5_core import embed_string, extract_string
import steganalysis as SA

clean = IO.load_as_gray("img/cover.png")
stego, report, nbits = embed_string(
    clean, "Hello nsF5!", method="nsF5", p=3, password="")
import os; os.makedirs("output", exist_ok=True)   # 仓库约定: 脚本产物写这里
IO.save_image(stego, "output/lab3_stego.png")
print("改动像素:", report["cover_changed"])
print("解码:", extract_string(stego, method="nsF5", p=3))
for name, im in (("干净", clean), ("含密", stego)):
    r = SA.analyze(im)
    print(name, "Gn=%.3f" % r["RS_Gn"],
          "chi2p=%.3f" % r["chi2_pvalue"],
          "prob=%.2f" % r["stego_probability"], r["verdict"])
动手做| 把消息改成 5000 个字符再跑一次(参考
src/test_steg.py),观察改动像素占比、Gn 下降幅度与隐写概率的变化。再换一张噪声较多的照片,看看卡方与 RS 是否还能区分。
3.7 小结与自我检查#
LSB 嵌入利用视觉冗余(图 3-2 每处只差 1),肉眼不可辨(图 3-1);
LSB 替换会拉平相邻灰度对频数(卡方可测)并破坏位面结构(RS 可测);
p 值高 ≠ 安全;要先判断图像本底是否天然随机;
误报/漏报不可兼得,灵敏度设置就是选择操作点;
项目 analyze() 是“统计信号 + 内容基线”的工程化组合。
想一想| 纯 LSB 替换“藏 1 bit/像素”,改动率平均 50%。如果只藏少量消息、改动不到 1% 像素,卡方还查得到吗?RS 呢?带着这个问题进入第 4 章。再想一层:既然 图 3-1 的 LSB 位平面本就近似噪声,为什么卡方还能抓住它?(提示:关键在于“干净图的奇偶频数原本不齐”,而不是“LSB 看起来乱”。)