第 9 章 · 工程化:C++、GPU、GUI 与测试(第 10 周)#
动手做| 本章目标:看懂“算法”如何变成“软件”;理解为什么需要 C++ 与 GPU 加速、如何保证跨语言一致;会运行测试与 CI 流程。
9.1 系统架构:分层而不耦合#
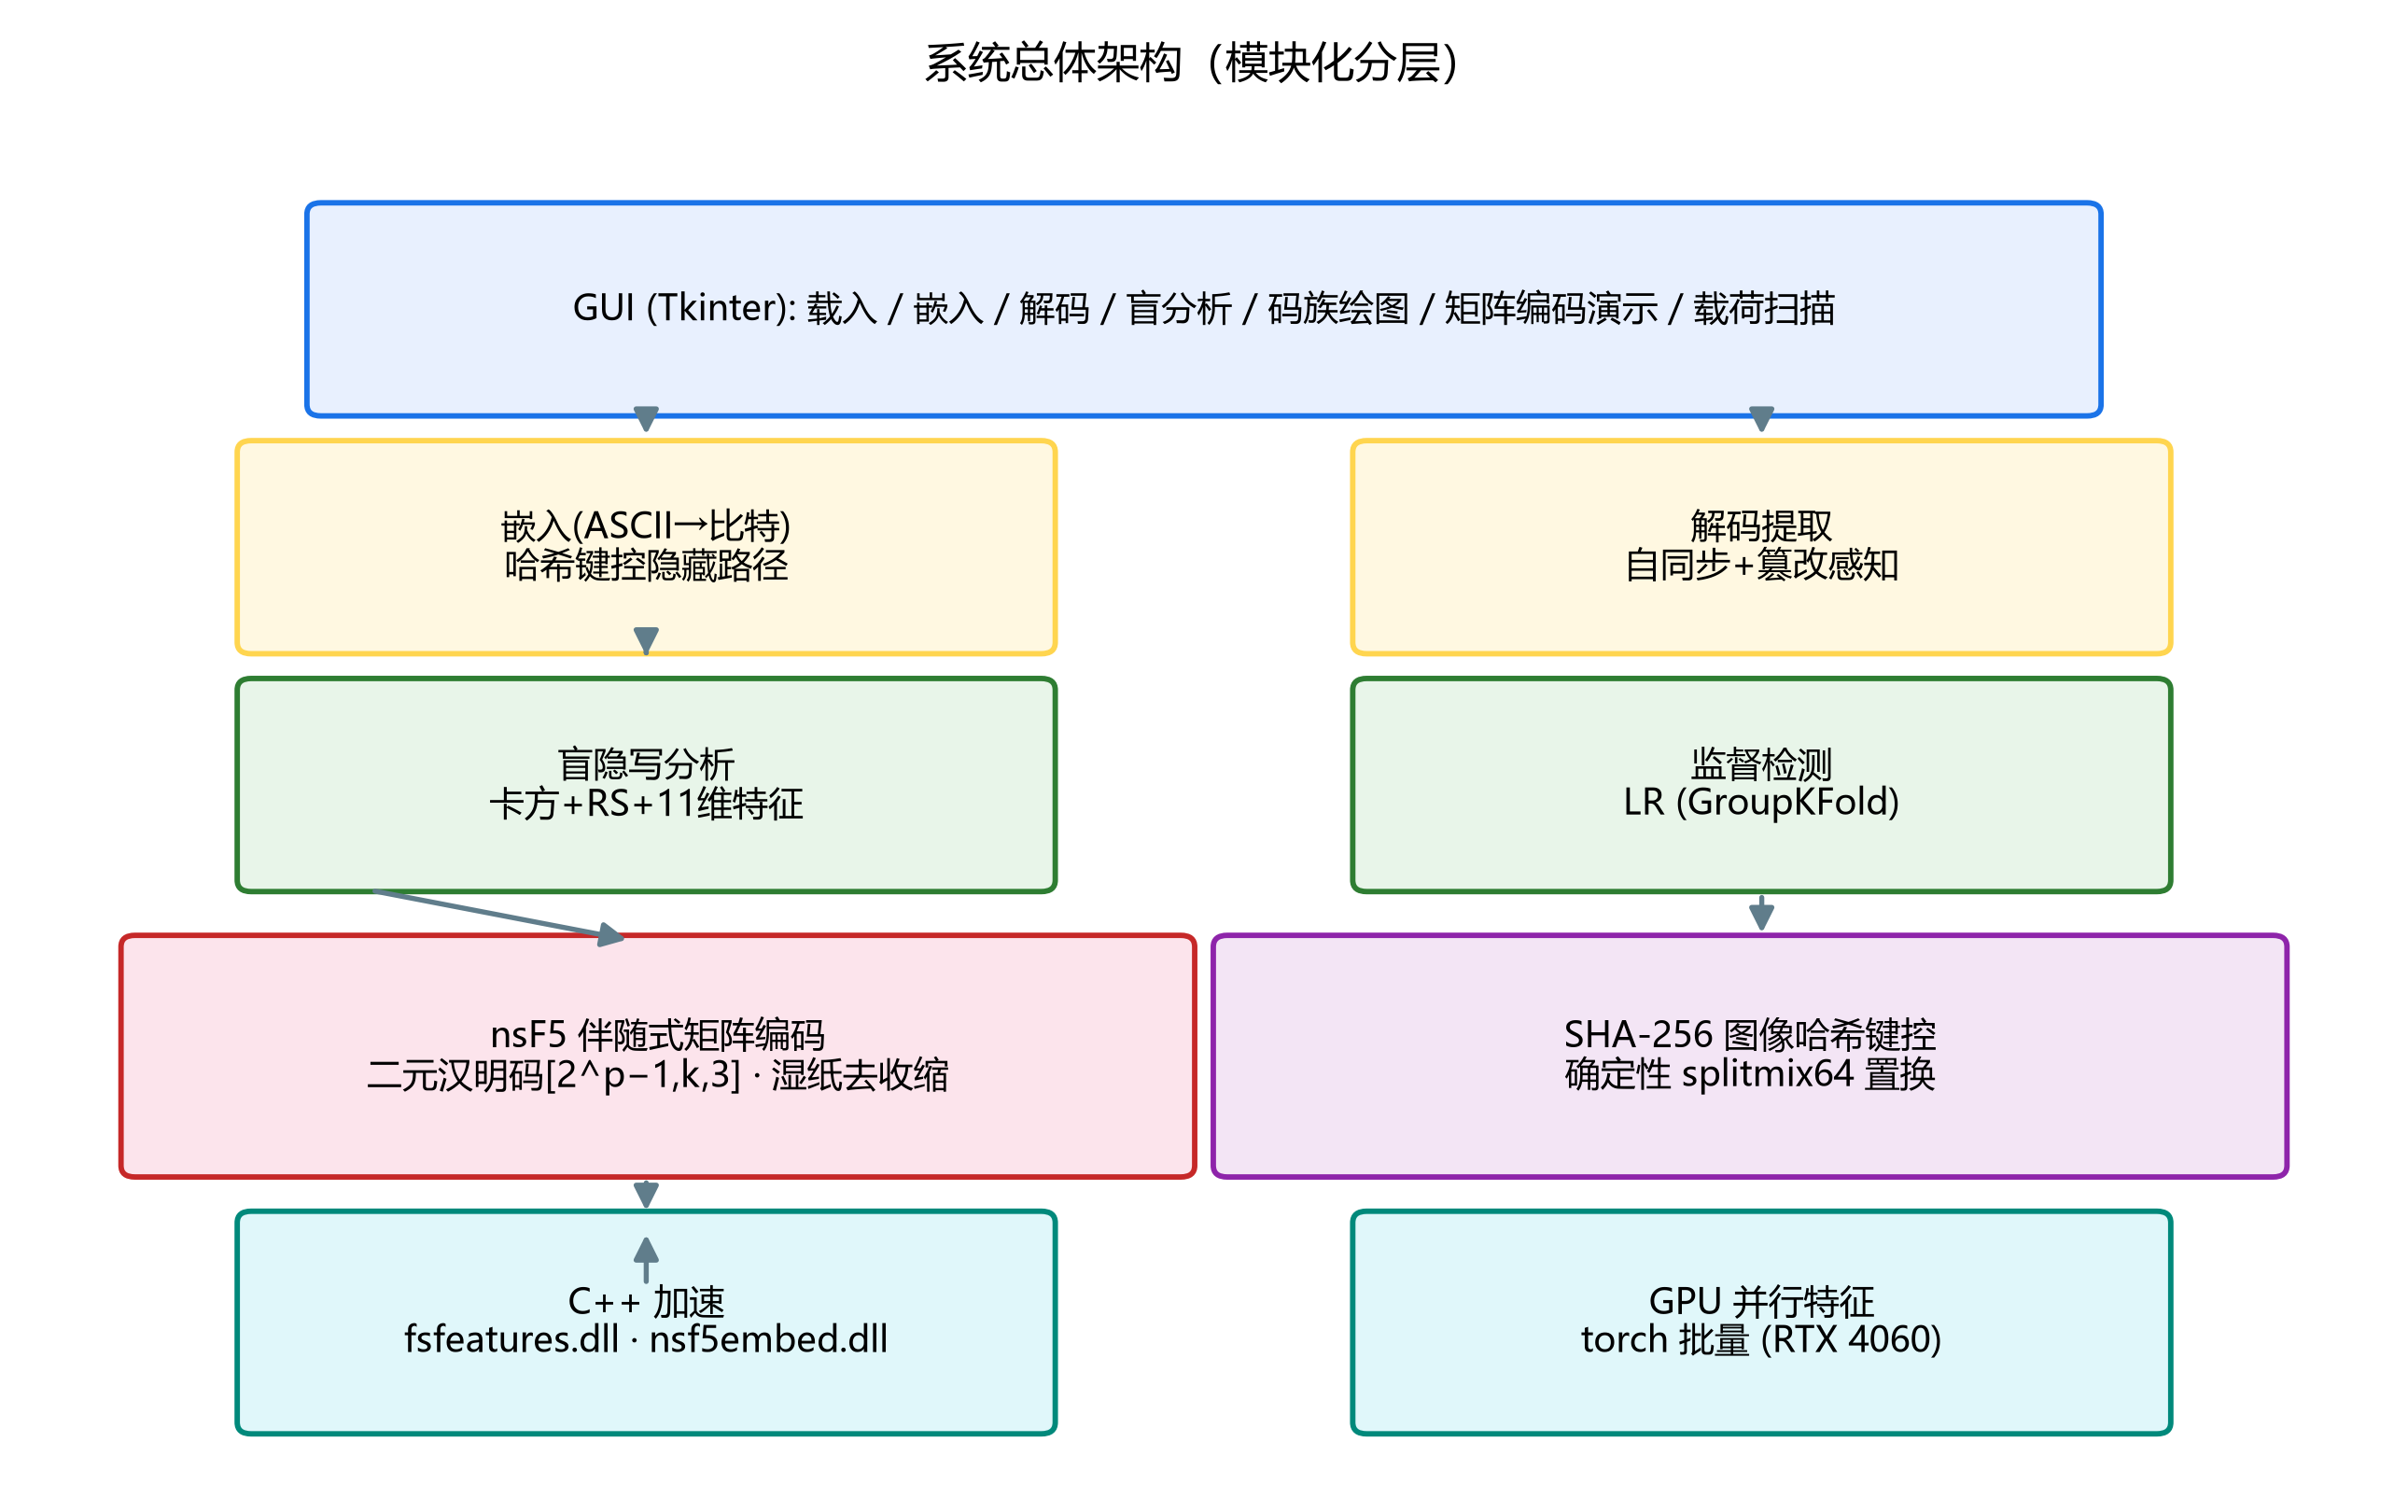
图 9-1 系统总体架构:底层加速 → 算法安全核心 → 功能层 → GUI(项目图)
加速层:
cpp/fsfeatures.dll(特征)、cpp/nsf5embed.dll(嵌入/置乱);算法核心:
ns5_core.py——汉明码、湿纸、哈希键控、嵌入/解码;功能层:
steganalysis.py、efficiency.py、make_dataset.py、train_model.py、ml_predict.py;界面层:
gui.py+matrix_demo.py+scan_panel.py,所有功能一键可点。
分层的意义:算法层不依赖 GUI,可以在无界面环境(服务器/CI)里跑;加速层 缺失时自动回退 Python,保证功能永远可用。
9.2 C++ 加速:为什么是“热路径”,以及如何保证没错#
Python 逐元素循环极慢,但隐写有两个典型热路径:确定性置换(把 1600 万 像素的顺序洗一遍)与特征提取(对每张图做 RS/卡方/熵统计)。把它们下沉到 C++ 动态库,性能可以提升几个数量级:置换加速随规模变化(数据见 experiments/data/bench_permute.csv,可用 python experiments/tools/gen_bench.py --only permute 复现;性能与机器相关):4096²(1600 万像素)Python ≈15.6 秒 → C++ ≈0.24 秒(约 65 倍),同一份基准里小规模(6.5 万)最高约 240 倍。
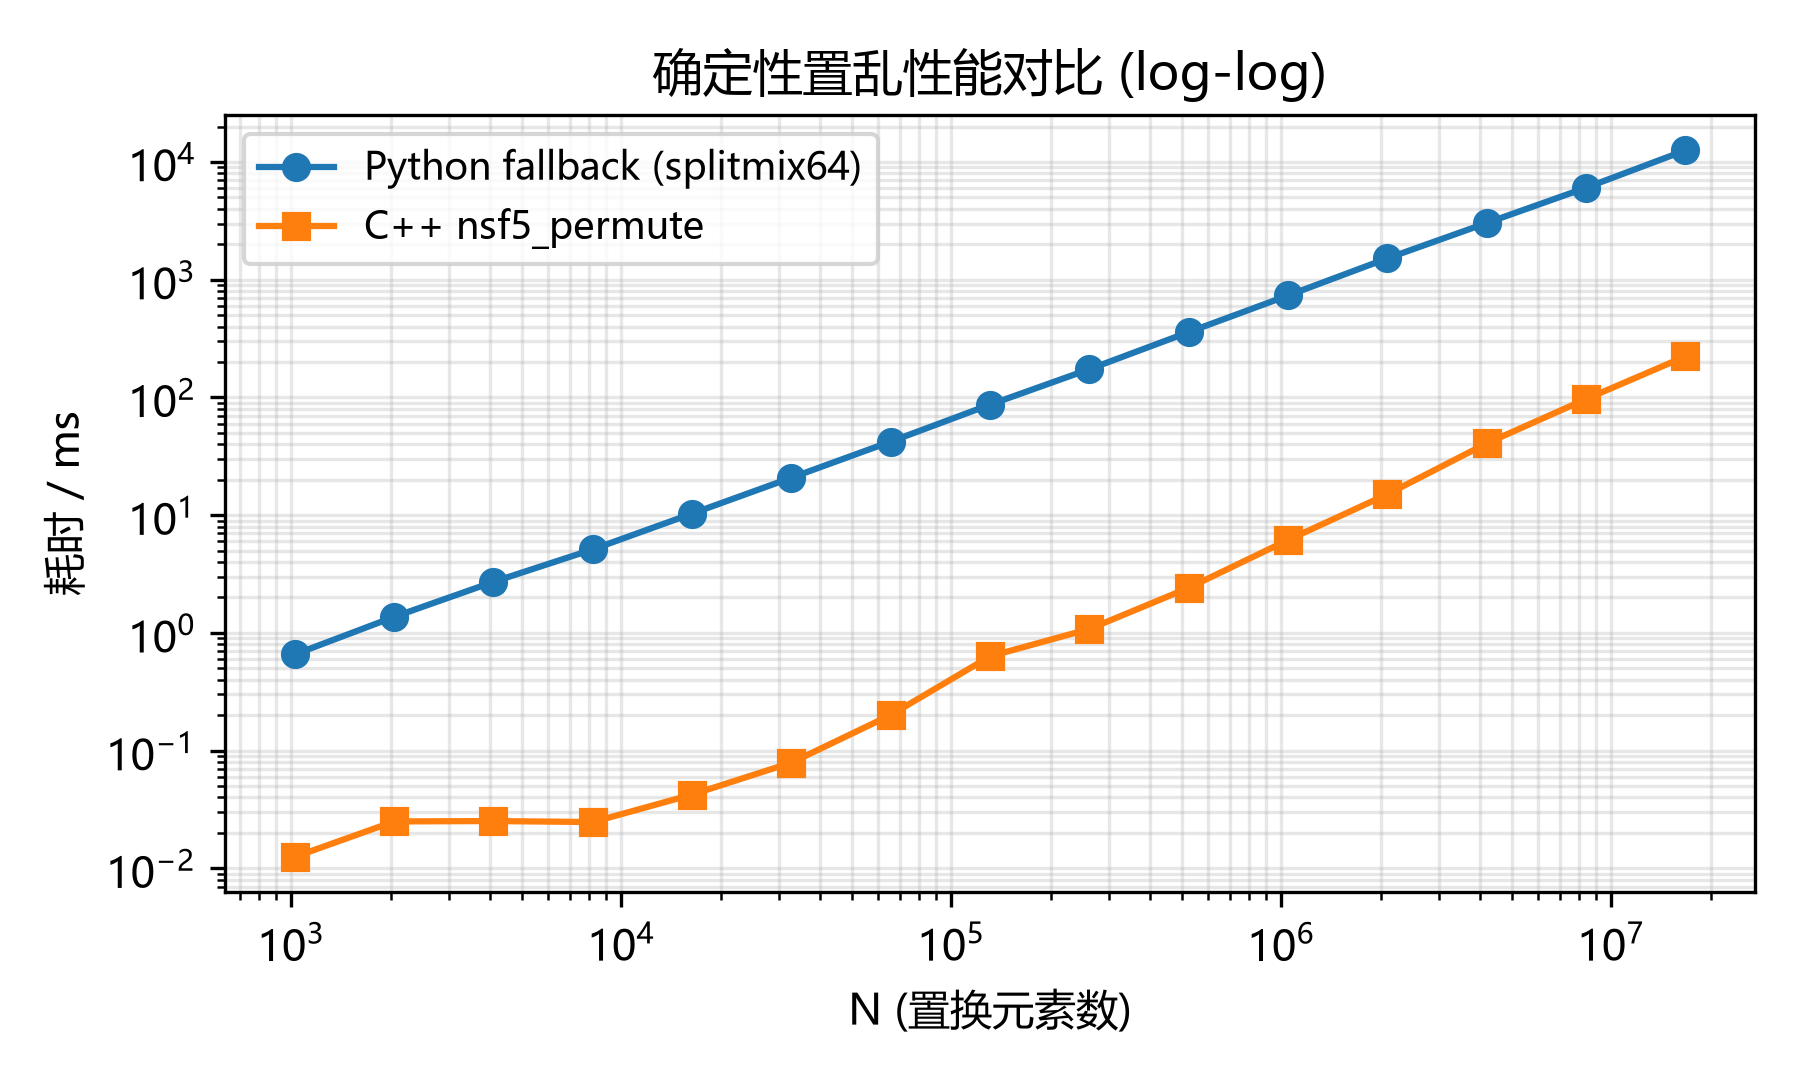
图 9-2 确定性置换性能:Python vs C++(log–log 坐标,项目图)
性能提升的前提是**“结果完全一样”**。Python 调 DLL 用的是 ctypes, 项目为此设计了自校验:
cppembed.py用同一图像分别走 C++ 与 Python 路径嵌入,比较输出是否像素级一致;fsfeatures.py的check_against_python()逐特征核对 C++ 与 Python 结果;DLL 缺失或加载失败时自动回退 Python 同算法,保证嵌入/解码两端序列恒定可逆。
避坑提醒| 跨语言一致性是“可加速”的前提,也是调试的雷区:C++ 端位运算、取整、溢出行为与 Python/NumPy 不完全一致。遇到“有 DLL 能嵌、无 DLL 解不了”的诡异 bug,先跑
cppembed.selfcheck()和fsfeatures.check_against_python(),而不是去改算法。
9.3 GPU 版:把 11 维特征“批量向量化”#
gpu/ 目录用 PyTorch 把特征计算改写成张量算子:一次读入一批 512×512 灰度图,在 GPU 上并行完成直方图、RS、卡方与熵计算,再落回 CPU。v1.4 新增 gpu/featurize_v2_gpu.py 支持 143 维 v2 特征(含 SRM 卷积)。README 实测 v1 特征 2070 张约 5 秒(≈410 张/秒),且与 CPU 参考实现逐位一致(浮点误差 ~1e-7)。
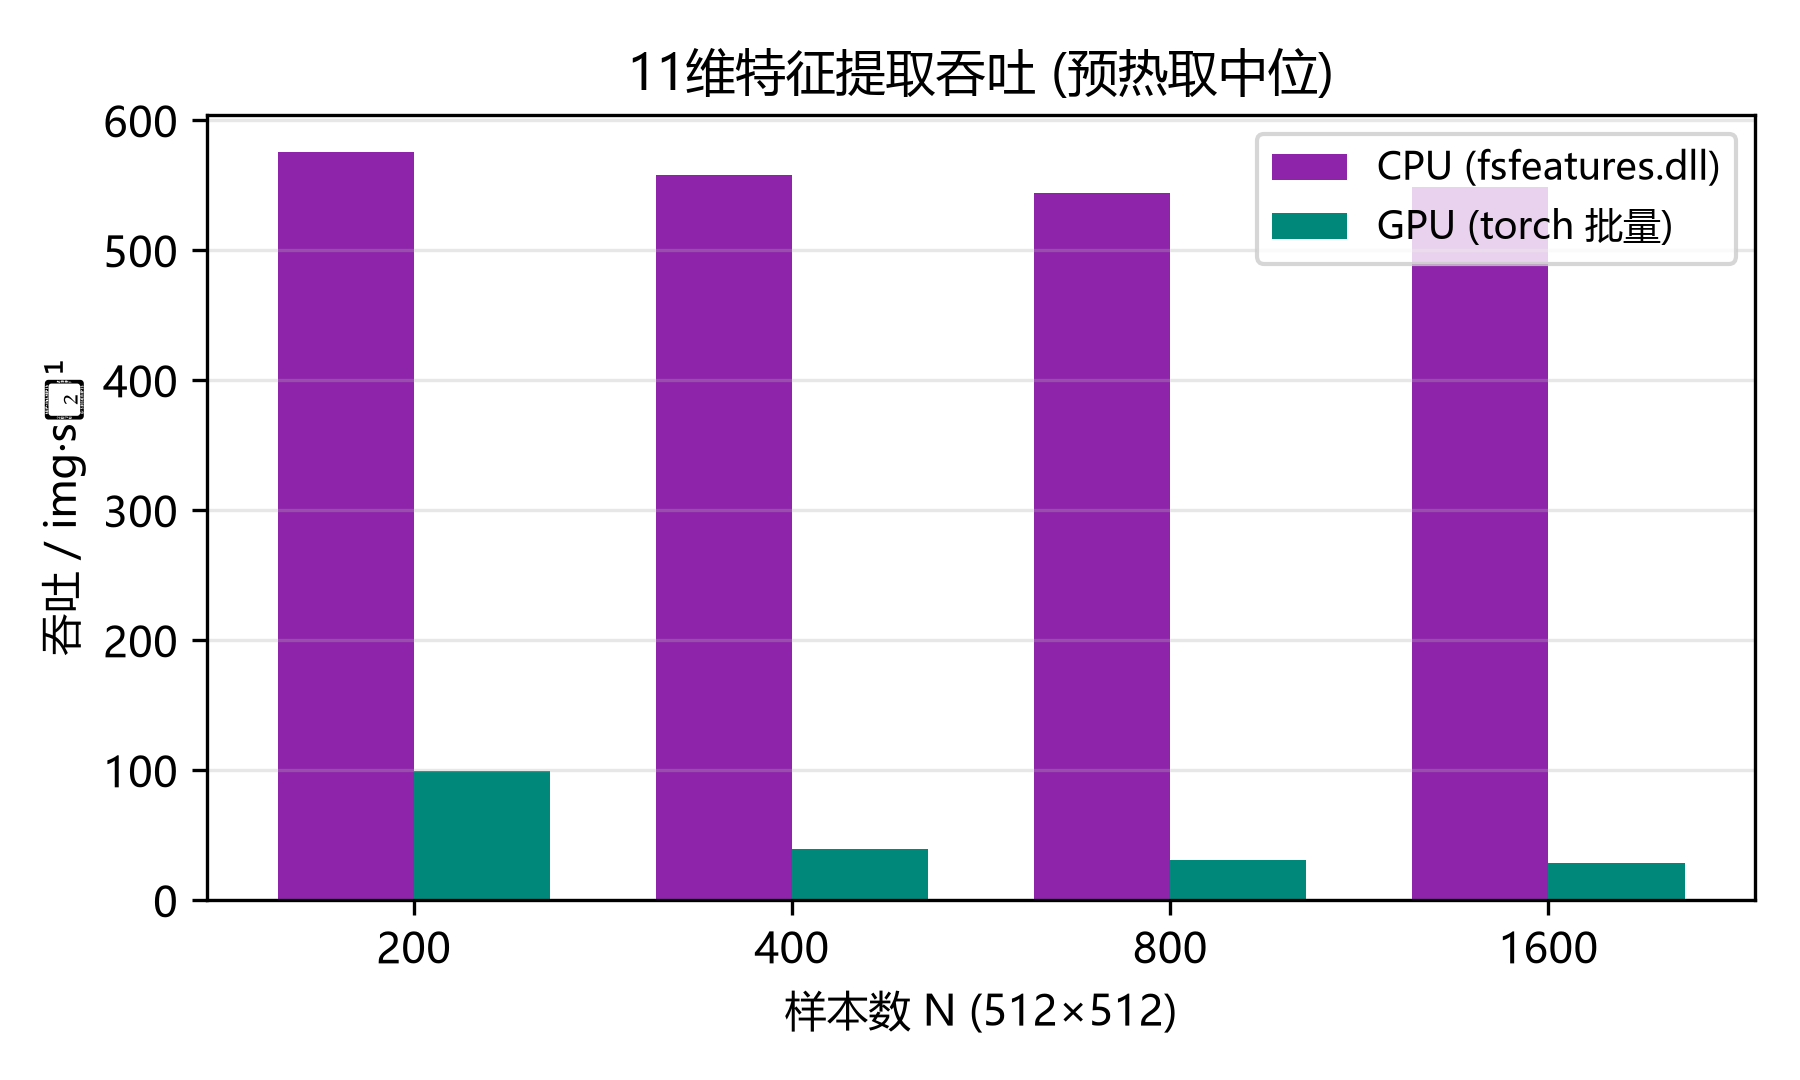
图 9-3 v1 11 维特征提取吞吐:CPU(C++) vs GPU(torch 批量)(项目图)
回到项目看代码| 读
gpu/featurize_gpu.py的自检函数:它把 GPU 结果与src/fsfeatures.py的 CPU 结果逐元素比较。bit 级一致是这套双实现能并存的前提。再读 README 关于吞吐边界的讨论:小批量时主机↔设备拷贝开销可能让 GPU 反而不如 C++——这是诚实评测,不是“GPU 一定更快”的营销话术。
9.4 GUI:把研究工具变成可教学的应用#
src/gui.py 的主界面围绕“嵌入→解码→分析”三步设计。真正出彩的是两个教学面板:
矩阵编码演示(
matrix_demo.py):随机/手点一个块,实时计算 s、m、d,高亮命中的列与被改系数,直观展示“至多改 1 位”;载荷扫描(
scan_panel.py):拖动 payload 0→0.4,逐档重新嵌入并刷新卡方 p 值、RS 估计率与 ML 概率三条曲线,观察“藏得越满越容易被发现”。
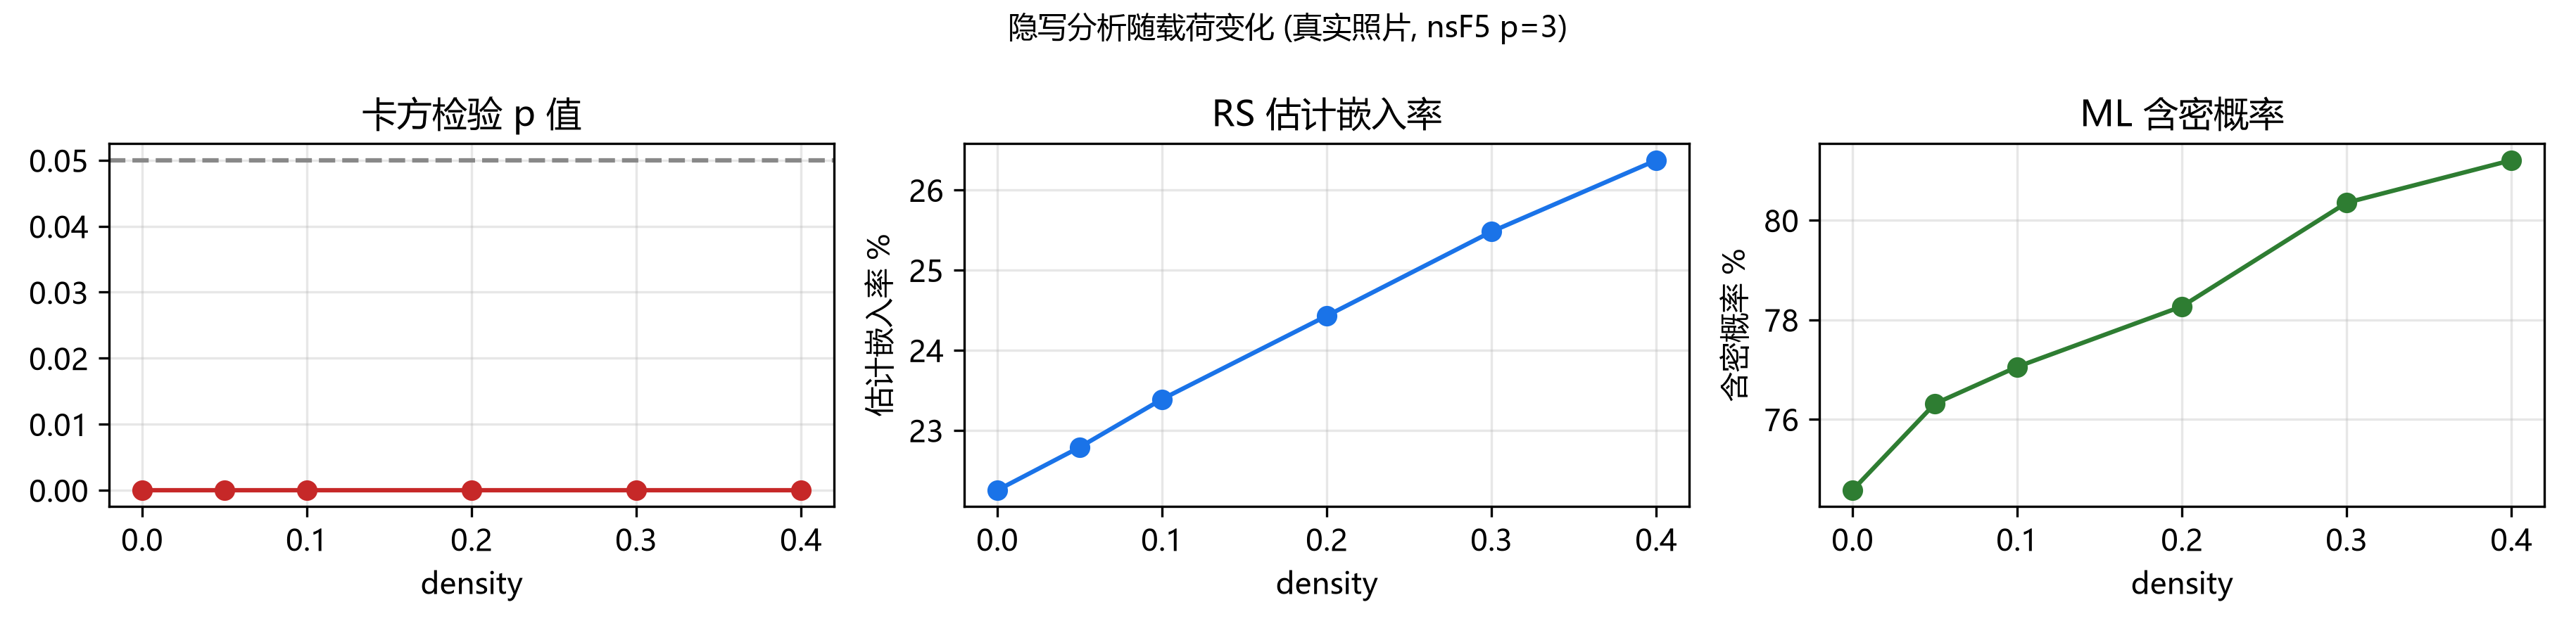
图 9-4 载荷扫描:统计可检测性随嵌入密度变化(项目图)
避坑提醒| 注意 GUI 文案里的严谨措辞:单张图没有“AUC”(AUC 需要一组正负样本),所以扫描面板用的是模型概率作为趋势示意。阅读软件输出时,要区分 “单图概率”与“数据集指标”,这是容易被误用的一处。
9.5 测试与 CI:让重构不翻车#
测试文件 |
验证内容 |
心智模型 |
|---|---|---|
test_core.py |
汉明矩阵正确性、嵌入/解码往返、湿纸、口令错误 |
算法没坏 |
test_steg.py |
盲分析能区分干净图与含密图 |
分析没坏 |
test_false_positive.py |
大量干净图不误报(回归) |
误报没失控 |
test_gui.py |
窗口能构建、载入与预览 |
界面没坏 |
.github/workflows/ci.yml 会在每次推送到 main 或提 PR 时自动跑核心测试、 构建 wheel 与 sdist;推送 v* 标签时自动发 GitHub Release。 这套“测试 + 打包 + 自动发布”是算法项目走向可复用工具的标准姿势。
9.6 代码阅读路线图(按需选用)#
入口:
src/run_e2e.py(最短路径,串起所有模块);数据层:
image_io.py→ 数组怎么进出的;嵌入层:
ns5_core.py从上到下读一遍(哈希、置换、汉明、湿纸、高层 API);分析层:
steganalysis.py的analyze()逆向追踪每个统计量;ML 层:train_model.py 主流程 → featurize_v2.py / srm_filter.py (v1.4)→ ml_predict.py 双版本推理;
加速层:
cppembed.py/fsfeatures.py的 ctypes 与自校验;界面层:
gui.py找按钮回调,顺藤摸瓜到算法函数。
想一想| 为什么
ns5_core.py的注释反复强调“改了置换算法会破坏可逆性”?请结合 v1.2.1 修复(DLL 缺失自动回退)想:如果 Python 与 C++ 排列不一致,会出现什么灾难性现象?
9.7 v1.4.0 更新:SRM、多源数据与模型工程(2026-09)#
v1.4.0 新增/改动了若干工程模块,阅读新代码时先认目录:
新文件 / 模块 |
职责 |
学习要点 |
|---|---|---|
src/srm_filter.py |
30 个标准 SRM 高通核,numpy/torch 双实现 |
核清单、归一化、增强图生成 |
src/featurize_v2.py |
143 维 v2 特征组装与 CPU 实现 |
ALL_FEATURE_NAMES、featurize_v2() |
gpu/featurize_v2_gpu.py |
GPU 批量 143 维特征与一致性自检 |
extract_features_v2_gpu() |
src/make_dataset.py 扩展 |
多进程 -j、SRM/feature-set/variants |
按图并行、输出逐行一致 |
src/train_model.py 扩展 |
DS_FILES 多数据集、Stacking、LGB 调优 |
双版本模型保存与阈值 |
gpu/make_imageset.py 扩展 |
memmap 逐张落盘、–out/–id-offset |
多源分工、避免 OOM |
数据侧:项目建立了纯校园照片基准 data/campus_jpg(414 张,移除早期 DIP4E 教材图),并引入隐写分析事实标准 BOSSbase 1.01(1 万张 512² 灰度 PGM)做多源合并。CPU 11 维合并训练 72898 样本,held-out AUC≈0.741;GPU 合并 52070 样本,验证 AUC≈0.712;BOSSbase 单独跑 GPU 只有 AUC≈0.644——基准越难,弱密度信号越弱。make_dataset.py 现在支持多进程(16 核约 5.6 倍加速),GPU 图像集用 memmap 逐张落盘避免大数组 OOM。
工程配套:许可证从 MIT 改为 Apache-2.0(新增 NOTICE 与第三方声明),README 与 pyproject 的版本/主页同步为 v1.4.0;C++ DLL 与 Python 的像素级/特征级一致性自检仍然保留。
动手做| 跑一次
python gpu\featurize_v2_gpu.py自检;然后按 README 用 data\campus_jpg 与 data\BOSSbase_1.01 各生成一源数据,对比“单源校园 / BOSSbase 单源 / 两源合并”三组模型的 AUC。这是 v1.4 最值得亲手复现的“数据域”实验。