nsF5 · 隐写互动实验室

零基础 · 双语 · 交互式

把文字藏进图片,
亲眼看见算法如何工作

在浏览器里动手实验 LSB、汉明伴随式矩阵编码、湿纸编码与机器学习隐写检测。每一步都有即时反馈。

  • 信息隐藏
  • 隐写分析
  • 机器学习
  • 6–12 个月路线
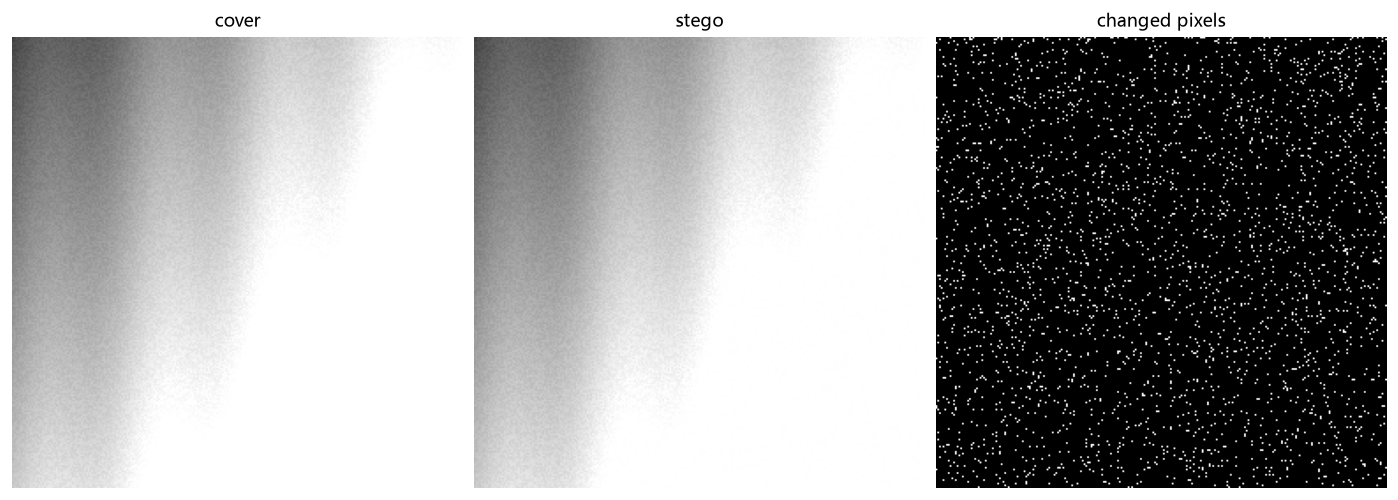
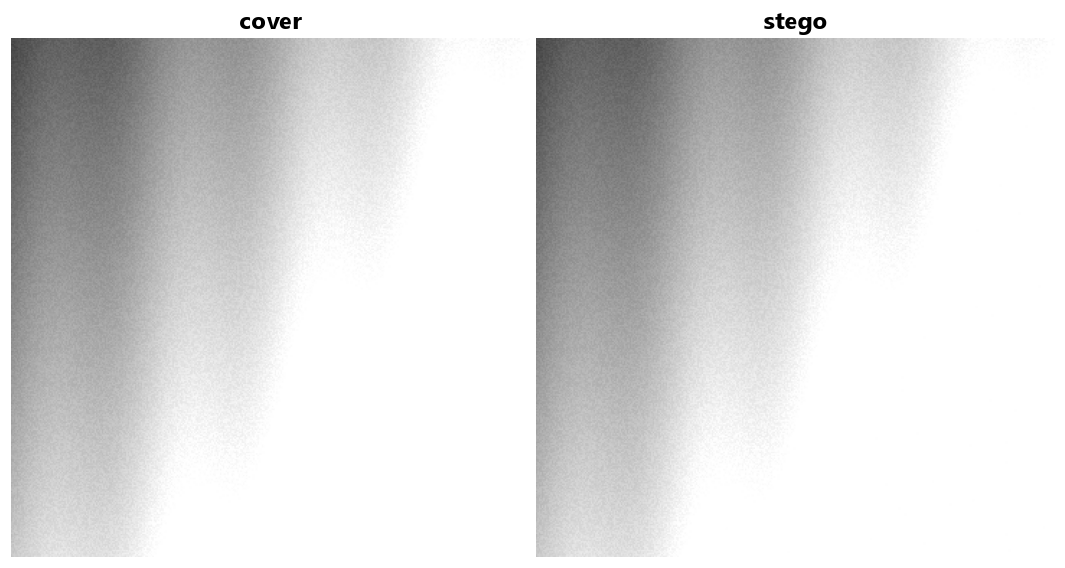
Cover and stego image side by side
原图(左)与藏入秘密后的含密图(右):肉眼几乎无法区分
第一部分 · 动手实验

实验 1 · 一分钟上手

位平面实验室:在像素 LSB 里藏一句话

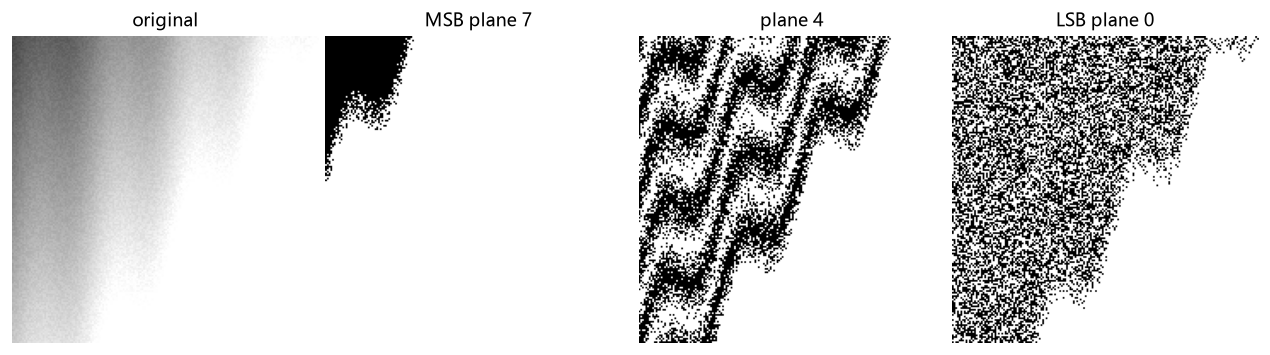
拖动位平面滑条观察图像被拆成 8 层;输入消息后,我们只修改最低位并统计被改变的像素。

LSB=1 比例: 50.0% · 修改像素: 0
-1 = 原始灰度图

  • 灰度值的最低一位叫 LSB;翻转 200↔201 人眼看不出差别。
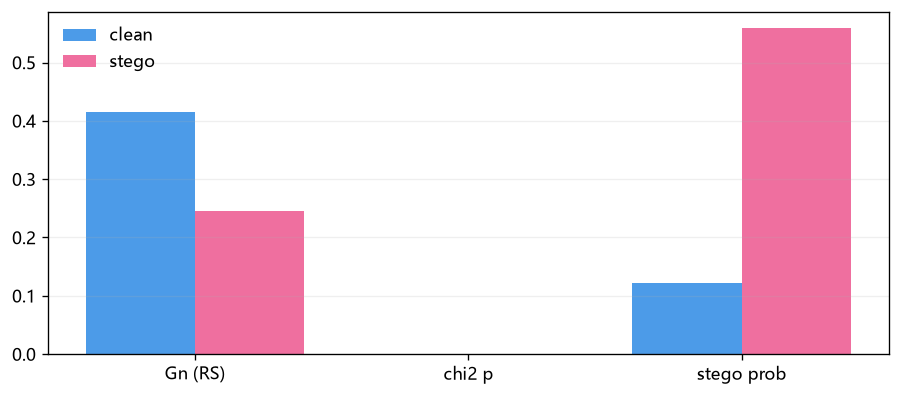
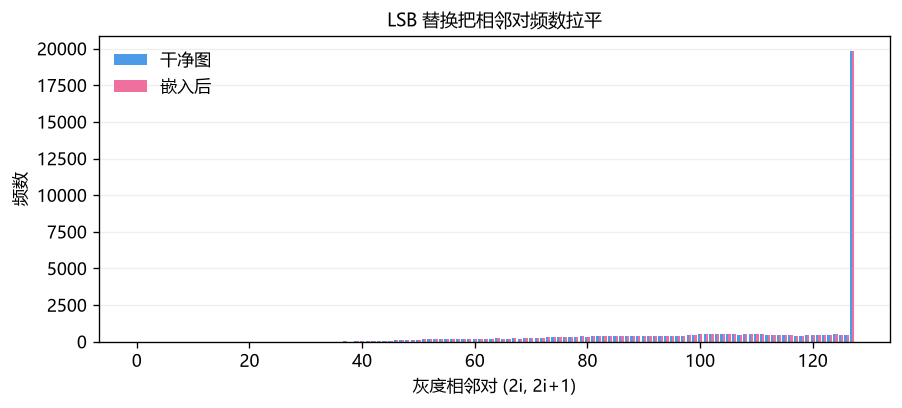
  • 直接替换 LSB 会留下统计指纹,可被卡方 / RS 分析发现(第 2 个实验旁有说明)。
尚未嵌入 —— 改动像素掩码为空

自测 · 看懂指纹

嵌入后立刻用卡方 / RS 分析它

点击「嵌入到 LSB」后,这里会用项目同一套统计量对当前图像做卡方检验与 RS 分析,看它是否留下"被嵌过"的指纹。

Bit planes of an image Clean vs stego statistics
Changed pixels after embedding Gray-level pair histogram before and after embedding
正在观察 bit 0(权重 ×1)· 黑白二值图

进阶 · 位平面分层

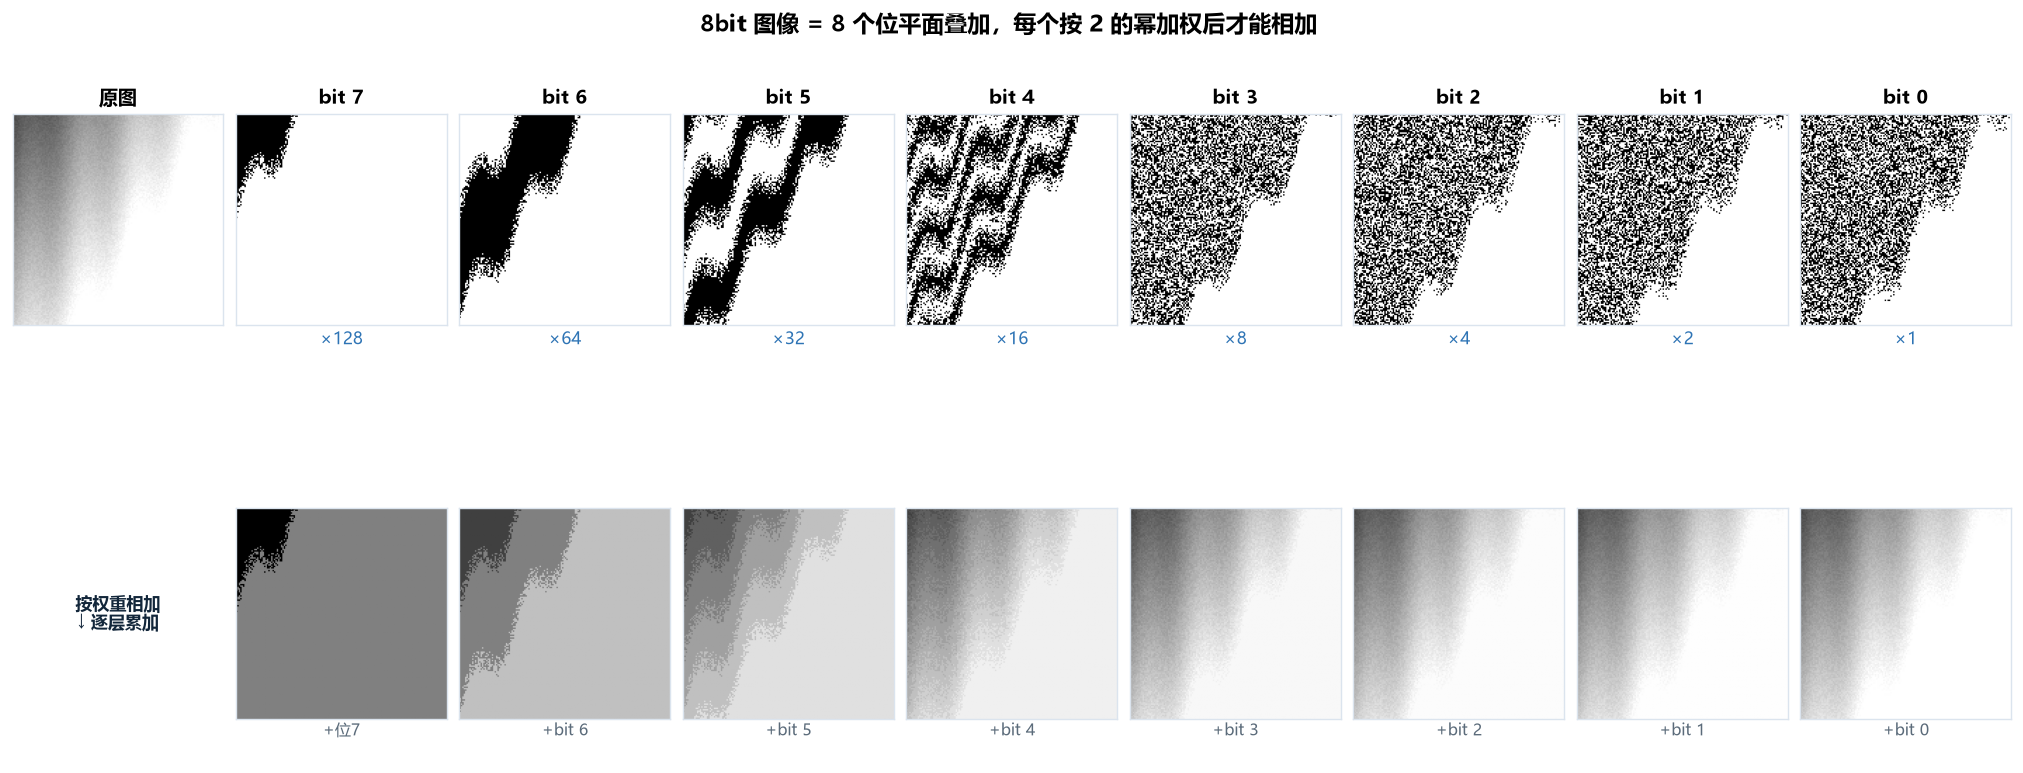
把 8bit 图像拆成 8 层:抽出单层看,或按权重重新叠加

点击下方位平面小块:单层模式下可抽出任意一位平面单独观察;叠加模式下可开关若干层,看加权和如何逐层逼近原图。

试试:叠加模式下先关掉 bit 0、1、2,画面变“平”;把 8 层全开则精确还原原图。

8-bit image split into 8 weighted bit planes that must be re-summed to reconstruct
8bit 图像 = 8 个位平面按 2 的幂加权后叠加。上图:8 层各自的二值平面(×128 … ×1);下图:按权重从最高位逐层累加,只有 8 层全加才等于原图——这就是“必须加权才能叠加”。
第一部分 · 动手实验

实验 2 · 项目的核心

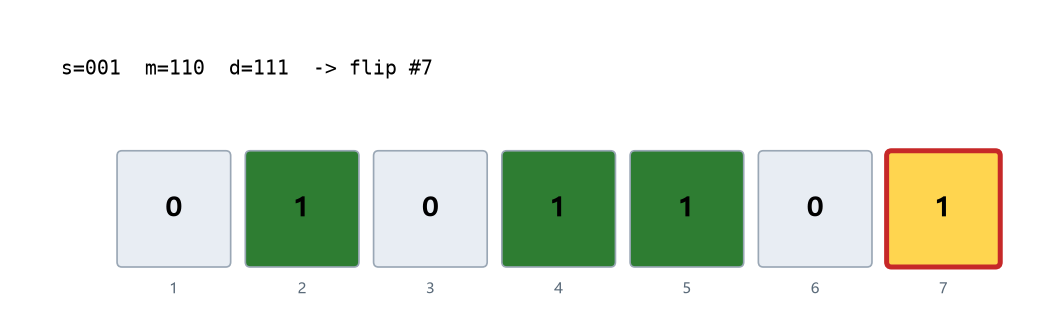
汉明伴随式编码:7 个位置承载 3 位,只改 1 位

点击格子手动翻转 LSB,或让系统自动找出“该翻转哪一个位置”,实时验证 H·x == m。

s=000 · m=110 · d=110 → 翻转第 6 位
  • 校验矩阵 H 的每一列都不同,所以“差值 d”永远能找到唯一要翻转的位置。
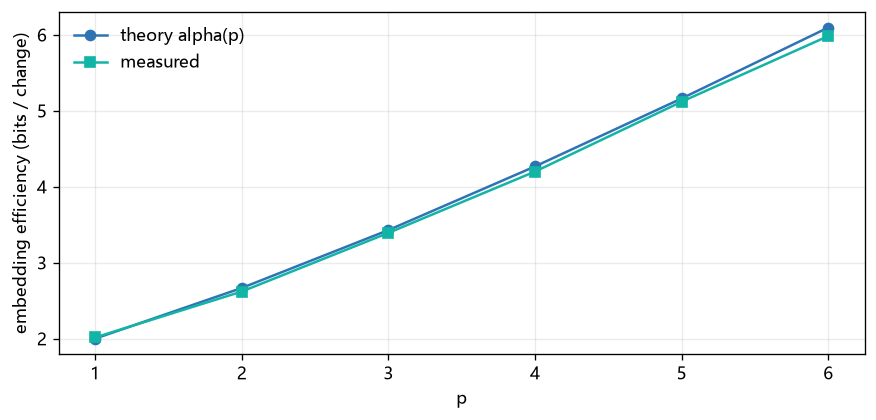
  • 平均每个块只需改动 0.875 次,就能携带 p=3 位消息——嵌入效率大幅提升。
黄格 = 建议翻转的 LSB
Syndrome matrix embedding illustration Embedding efficiency curve
第一部分 · 动手实验

更深入一步

湿纸编码:把“会变成 0 的位置”划为湿点

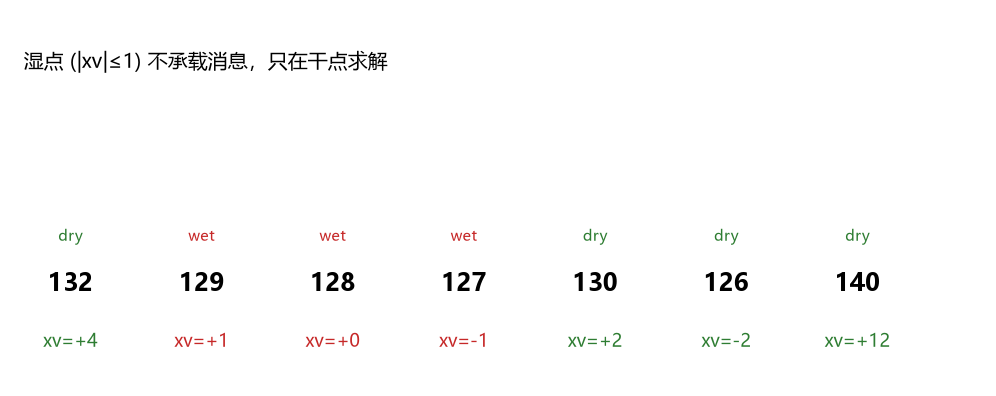
像素减 128 后,|xv|≤1 的像素像“被水浸湿的纸”。nsF5 不碰它们,只在干点上解 GF(2) 方程——无收缩、无重试。

Wet and dry coefficient positions
s=… · m=… → solve on dry

提示:点击格子可在“湿/干”之间切换,观察干点不足时会发生什么。

危险像素

127 / 128 / 129(即 xv = −1, 0, +1)减幅会撞零,标记为湿点。
干点求解

只在干列上求伴随式方程 H·y = d,优先单列、双列,再高斯消元兜底。

无收缩

每个块都能一次成功,容量与嵌入效率逼近汉明码理论上限。

第一部分 · 动手实验

实验 4 · 项目真正的算法

nsF5 对比实验室:矩阵编码 + 减幅修改 + 跳过湿点

同一句话、同一张图:分别用“朴素 LSB 替换”与项目真实的 nsF5 算法(对应 ns5_core.py 的 nsF5Pixel._embed)嵌入,对比改动数量、分布与统计指纹。

尚未嵌入 —— 画布显示原图

  • nsF5 把像素按 n=2^p−1 分块,每块用伴随式编码装 p bit:通常只需改 1 个像素,嵌入效率从 1 bit/改动 升到约 3.4 bit/改动(p=3)。
  • 修改方式不是“翻转 LSB”而是“减幅”(133→132、126→127),且 127/128/129 这类湿点交给湿纸方程避开——所以 LSB 结构更难被卡方/RS 抓住。
尚未嵌入 —— 差异图为空(白 = 被修改像素)

读数 · 谁的指纹更弱

改动统计 × 同一套卡方 / RS 检测器

嵌入后读两行数:上面是改动统计(含 PSNR),下面是检测器的判定。两种方法各嵌一次,对比指纹强弱——这就是矩阵编码的意义。

第一部分 · 动手实验

实验 5 · JPEG 压缩域

JPEG 压缩域:在 8×8 量化 DCT 系数上做 nsF5

前面的实验都发生在像素上,而教科书里的 nsF5 发生在 JPEG 的量化 DCT 系数上。这里把一个 8×8 块的量化系数摊开给你看:载体是谁、湿点是谁、"+3→+2" 长什么样。

上:8×8 像素块 · 下:量化 DCT 系数。灰格 = 量化后归 0 的高频 · 蓝框 = |c|=1 湿点 · 红框 = 被修改的系数

  • JPEG 先把图切成 8×8 块做 DCT,再除以量化表取整:大多数高频系数归 0,活下来的非零 AC 系数才是载体——质量越高,量化步长越小,载体越多。
  • F5 的修改是“幅值减 1、保符号”:+3→+2、−5→−4。|c|=1 的系数再减就归零(收缩),被划为湿点,由湿纸方程在干点上求解避开。
  • 这条算法已在项目主线里(姊妹项目 yccstego,经 jpegstego.py 桥接):命令行 `nsf5stego embed --jpeg` 在真正的 JPEG 上做这件事,GUI 参数区切到“JPEG 域”即可。
第二部分 · 原理分析

一张图看懂

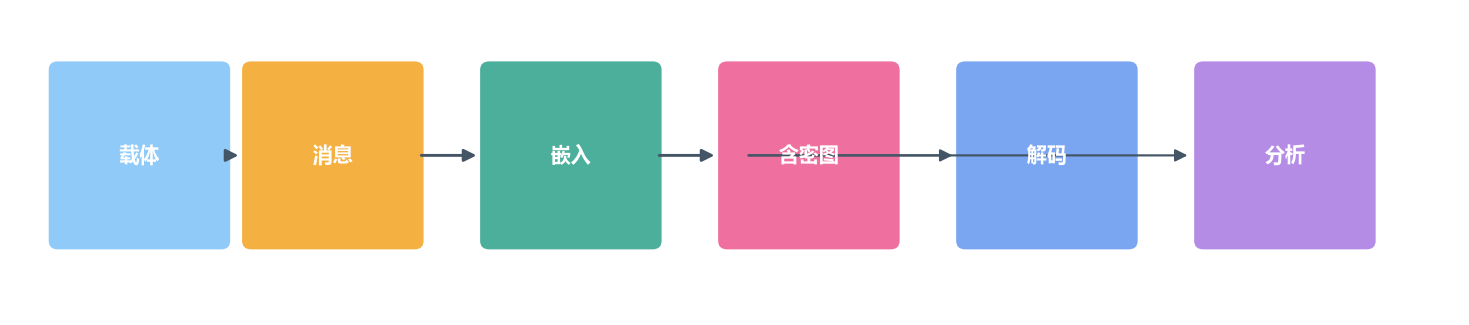
从“藏”到“查”:完整数据流

Embedding, decoding and steganalysis pipeline

嵌入端

消息 → 长度头 + SHA-256 键控 → 汉明/湿纸编码 → 写入 LSB → 含密图。

解码端

重算内容哈希 → 恢复路径 → 提取伴随式 → 还原消息;被篡改会自同步失败。

分析端

卡方 / RS / 11-143 维特征 + 双版本 LGB 模型输出含密概率。

第二部分 · 原理分析

机器学习检测

机器如何“看出来”图片藏了东西

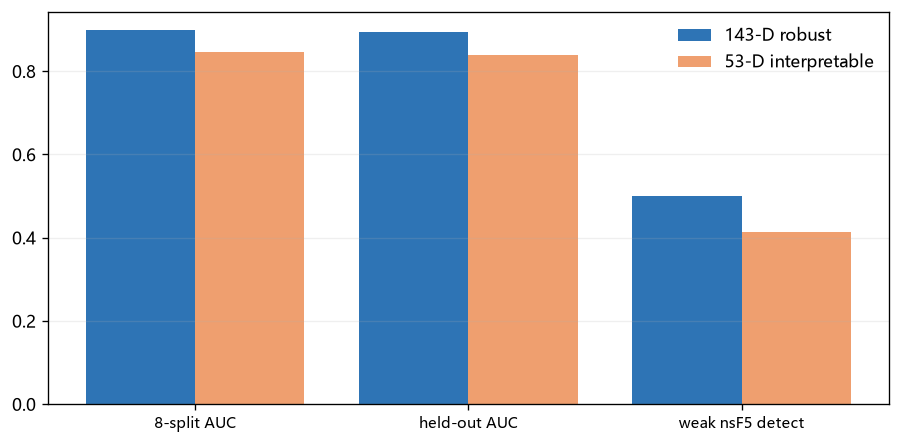
先手工设计能度量 LSB 足迹的特征,再用分类器学一个判别边界;项目同时保留“稳健 143 维”与“可解释 53 维”两套模型。
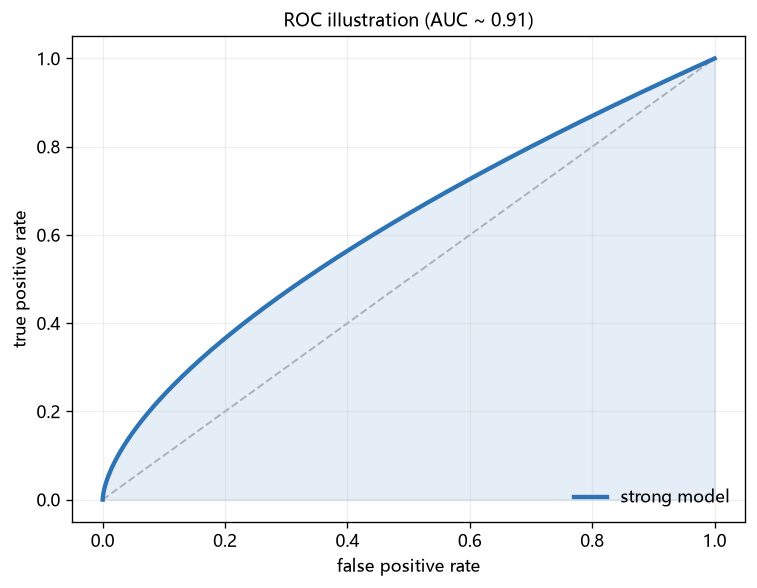
ROC curve illustration Dual model comparison chart
FP=… · FN=…
0.0

红线向右 = 更严格(误报少、漏报多);向左 = 更宽松(检出高、误报多)。

d=0.00 · chi2 p=… · RS=…% · ML=…%
0.00

用项目真实统计量观察“藏得越多越容易被发现”:拖动滑块看三条曲线同步移动。

为什么不用裸像素 CNN?

弱 LSB 信号 + 独立样本只有照片数;特征法在同样小数据上更稳、更可解释。

GroupKFold

同一张照片的所有变体只能同进同出,防止“同源泄漏”让 AUC 虚高。

双版本策略

143d 判得更准(AUC 0.90 vs 0.85),代价是 SRM 90 维难以解释;53d 去掉 SRM 后每个特征都能解释,AUC 略低。

第三部分 · 学习路径

6–12 个月学习路线

从入门到研究,逐月进阶

下面是 12 周快速入门计划;完整课程为 6–12 个月(基础 / 提高 / 深化 / 实战四段),见手册附录 F。

    第三部分 · 学习路径

    继续深入

    手册 · Notebook · 源码

    同类工具与本项目的定位

    这个领域并不缺研究工具——Aletheia(Python 隐写分析工具箱)、CONSEAL(C++ 特征库)、DDE Lab 工具集等。本项目不替代它们:定位是交互教学、可视化与可复现实验(每步可导出档案、一键重跑)。完整对比见仓库 README 的「同类工具与本项目定位」。

    第四部分 · 常见问题

    快速答疑

    常见问题(FAQ)

    实验与原理中最高频的疑问,点开逐条查看。

    还有问题?

    先看手册第 3、8 章:LSB 卡方/RS 分析与第 8 章特征工程。

    想自己算一遍?

    仓库附 10 个章节 Notebook(对应第 1–10 章),含汉明矩阵、湿纸求解与 ML 特征/推理全流程。

    能商用吗?

    项目采用 Apache-2.0 许可,可自由用于教学、研究与商用,只需保留版权与许可声明(见 LICENSE / NOTICE)。

    第五部分 · 自测

    学完自查

    自测一下:选一选 + 对答案

    每题选出你认为正确的选项,点“检查答案”看对错与解析;全部答完可累计得分。

    得分 0 / 0